유튜브 분석 보는 법, 꺾인 시각은 위치 값이 아니라 구간 가운데다
유튜브 분석 보는 법의 첫 함정은 시청 지속 표 파일의 위치 값을 그대로 시각으로 읽는 것입니다. 위치는 구간의 시작이고 통계 API는 끝이라, 11분 영상에서 3.4초가 밀려 재검토할 대사를 엉뚱하게 짚습니다. 영어 유튜브 스킬 11개를 한국어 채널에 돌린 실측으로 설명합니다.
방구석컴퍼니
혼자 일하는 사람 · 작업 기록
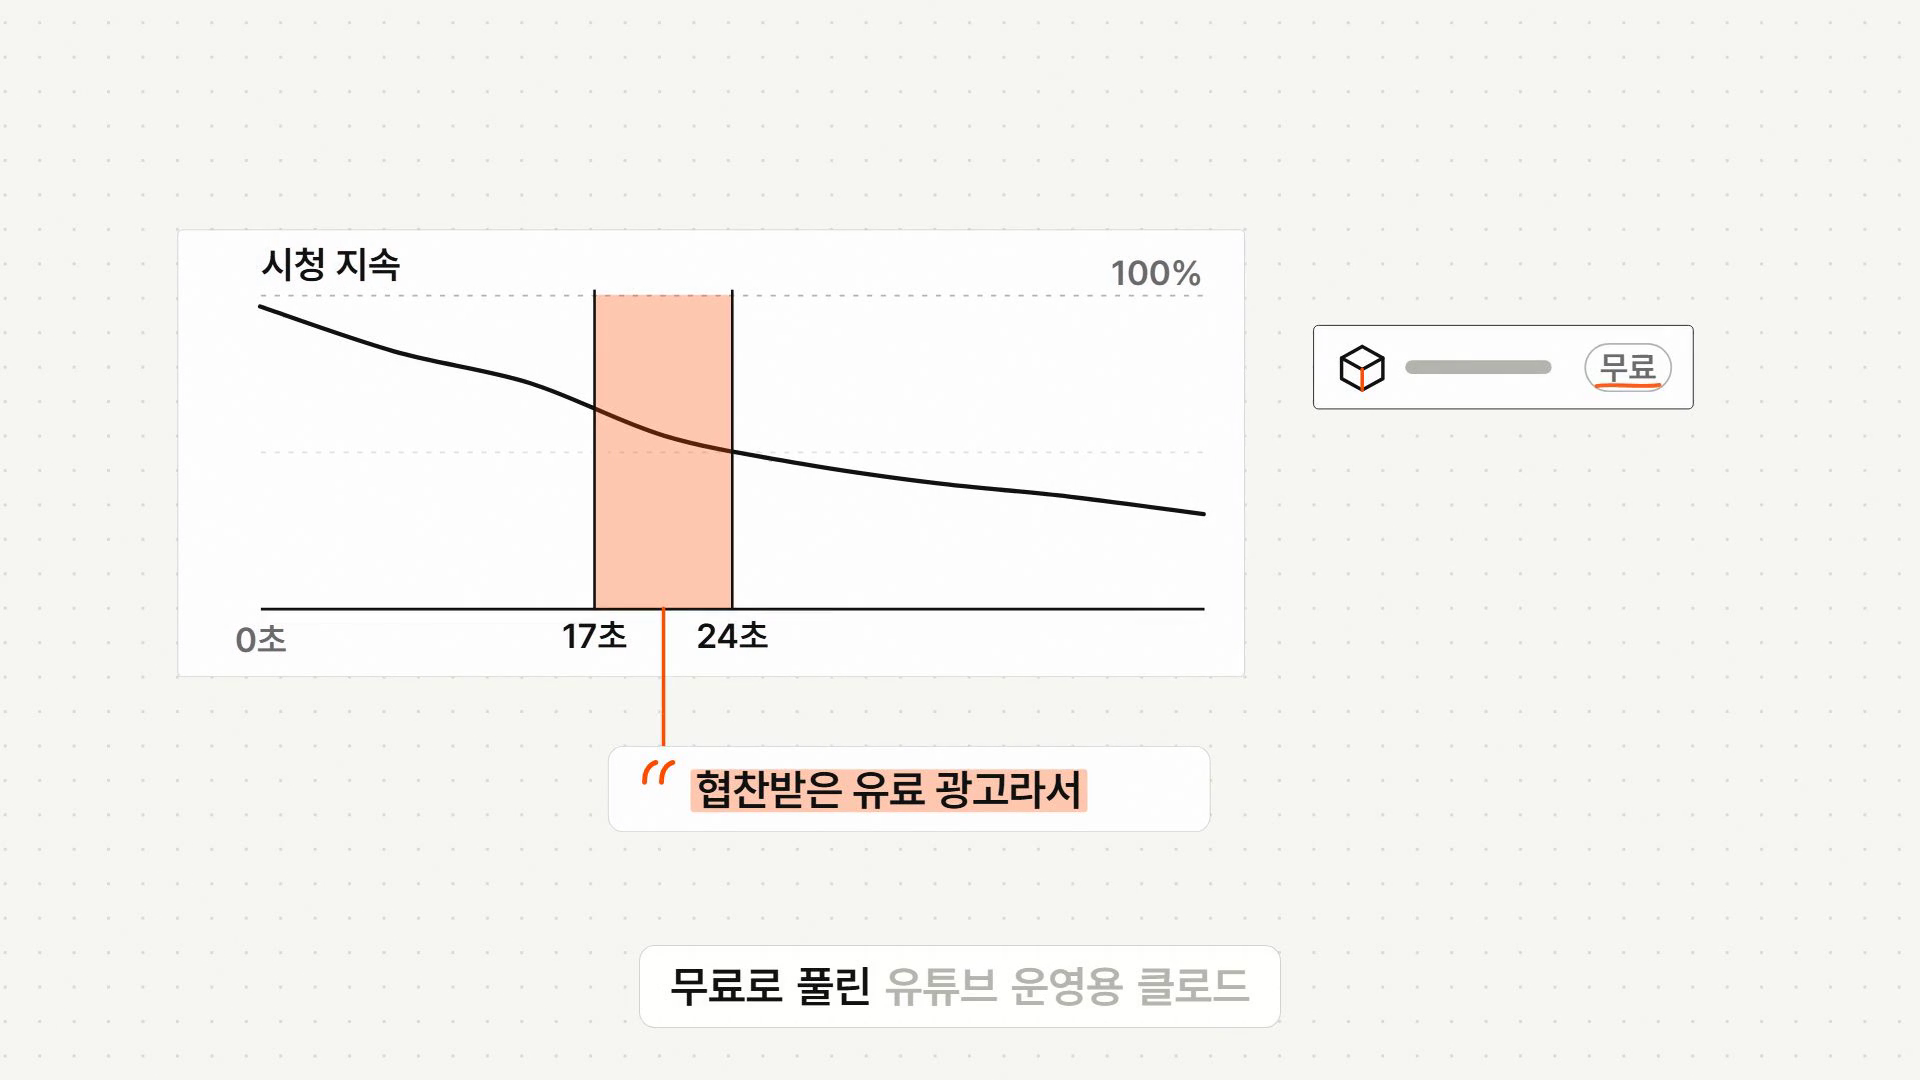
제 협찬 영상은 0:17부터 0:24 사이에 시청자 16.9%p를 잃었습니다. 같은 표 파일을 넣었는데 영어 원본 도구는 그 하락을 14초에 찍었고, 한국어판은 0:17~0:24에 찍었어요. 3초 남짓 차이인데, 그 차이 때문에 원본은 협찬 고지가 아니라 그 앞 문장을 재검토 대상으로 보여 줬습니다.
유튜브 분석 보는 법에서 가장 먼저 걸리는 게 이 시각 문제예요. 결론부터 말하면 스튜디오 시청 지속 표 파일의 위치 값은 구간이 시작하는 곳이라, 그대로 시각으로 쓰지 말고 구간 가운데로 바꿔 읽어야 합니다. 그래프는 보는데 어느 구간의 무슨 말을 다시 봐야 할지 못 찾던 분, 깃허브에 무료로 풀린 영어 유튜브 스킬을 한국어 채널에 써 보려다 결과가 이상해 막힌 분께 변환 구조를 이해할 수 있게, 원본 11개를 제 채널 자료로 전부 돌린 숫자로 설명합니다.
그래프 숫자와 대사를 한 화면에 붙이는 구조
시청자가 빠진 구간과 그때 나온 말을 맞추려면 두 파일이 필요합니다. 스튜디오 고급 모드에서 내려받는 시청 지속 표(CSV, 쉼표로 값을 나눈 표)와 그 영상의 자막 파일이에요.
리텐션 도구는 표의 100개 값을 영상 시각으로 환산하고, 낙폭이 큰 순서대로 구간을 고른 뒤, 해당 시각의 자막 줄을 함께 보여 줍니다. 구조는 단순해요. 대신 시각 변환이 한 번 어긋나면 엉뚱한 문장이 붙습니다. 이 글의 나머지는 대부분 그 어긋남 이야기예요.
표 파일의 위치 0은 구간이 시작하는 곳이다
스튜디오 고급 모드에서 내려받은 "전체" 표 파일을 열면 위치가 0부터 99까지 있습니다. 영상을 100개 구간으로 나눈 번호예요.
여기서 위치 0은 첫 1% 구간이 시작하는 지점을 가리킵니다. 위치 17이면 영상의 17% 지점부터 18% 지점까지라는 뜻이에요.
통계 API는 같은 구간을 끝으로 적는다
유튜브 통계를 프로그램으로 받는 창구(YouTube Analytics API)도 영상당 100개 지점을 줍니다. 그런데 구글 공식 문서는 이 값을 구간의 끝이라고 적어 두었어요. 0.01은 첫 1% 구간이 끝나는 지점입니다.
두 출처의 같은 구간을 비교하면 값 차이는 평균 0.37%p로 작습니다. 문제는 값이 아니라 시각이에요.
섞으면 11분 영상에서 3.4초가 밀린다
11분 25초 영상이면 한 구간이 6.85초입니다. 시작으로 읽느냐 끝으로 읽느냐에 따라 같은 하락이 반 구간씩 앞뒤로 움직여요. 그 반 구간이 3.4초입니다.
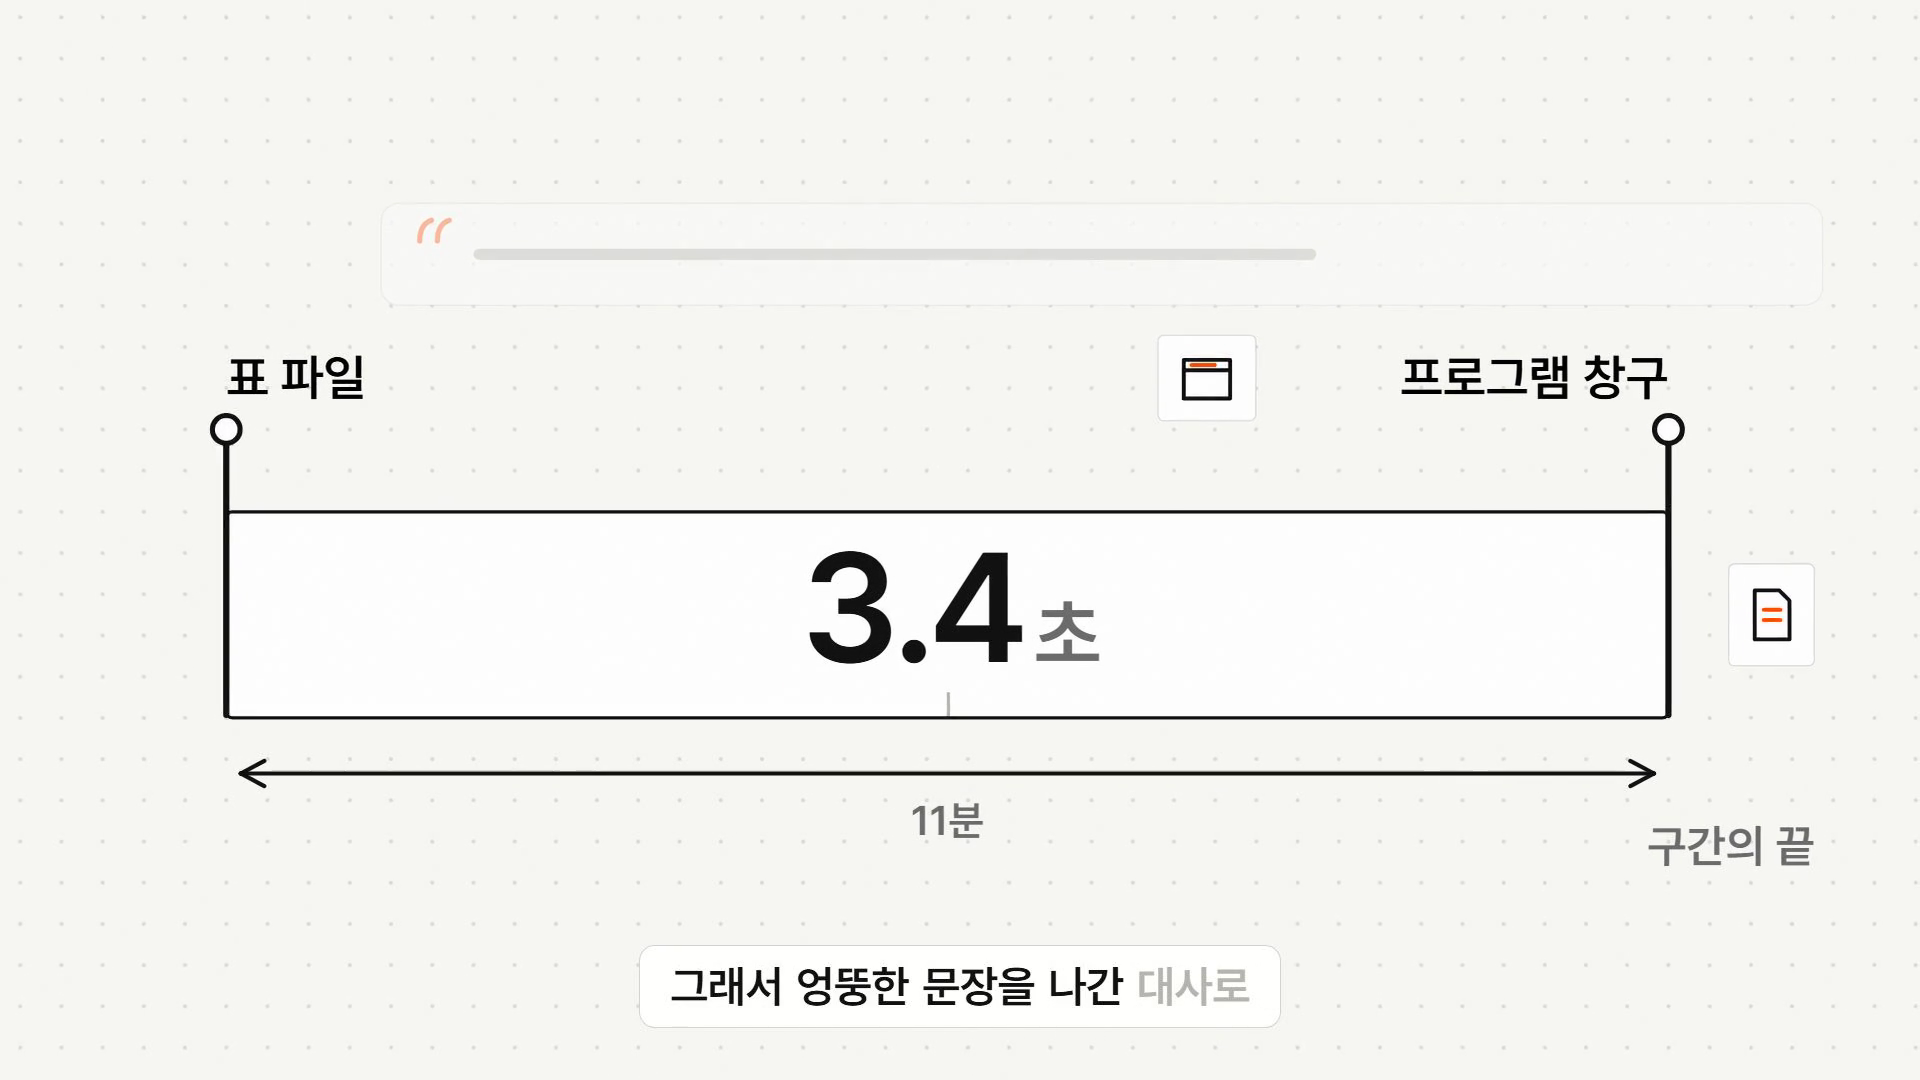
3.4초는 한국어로 짧은 문장 하나 분량이에요. 성인 낭독 속도(1분에 약 308음절, 안종복 외 2002)로 치면 17음절쯤입니다. 그래서 시각이 반 구간만 밀려도 "나간 순간에 한 말"이 옆 문장으로 바뀝니다.
원본은 같은 하락을 찾고도 앞 문장을 보여 줬다
영어 원본 리텐션 도구는 표 파일 위치 값을 그대로 시각으로 씁니다. 그래서 가장 큰 하락(16.9%)은 잡아냈지만 시각을 14초로 앞당겨 찍었어요.
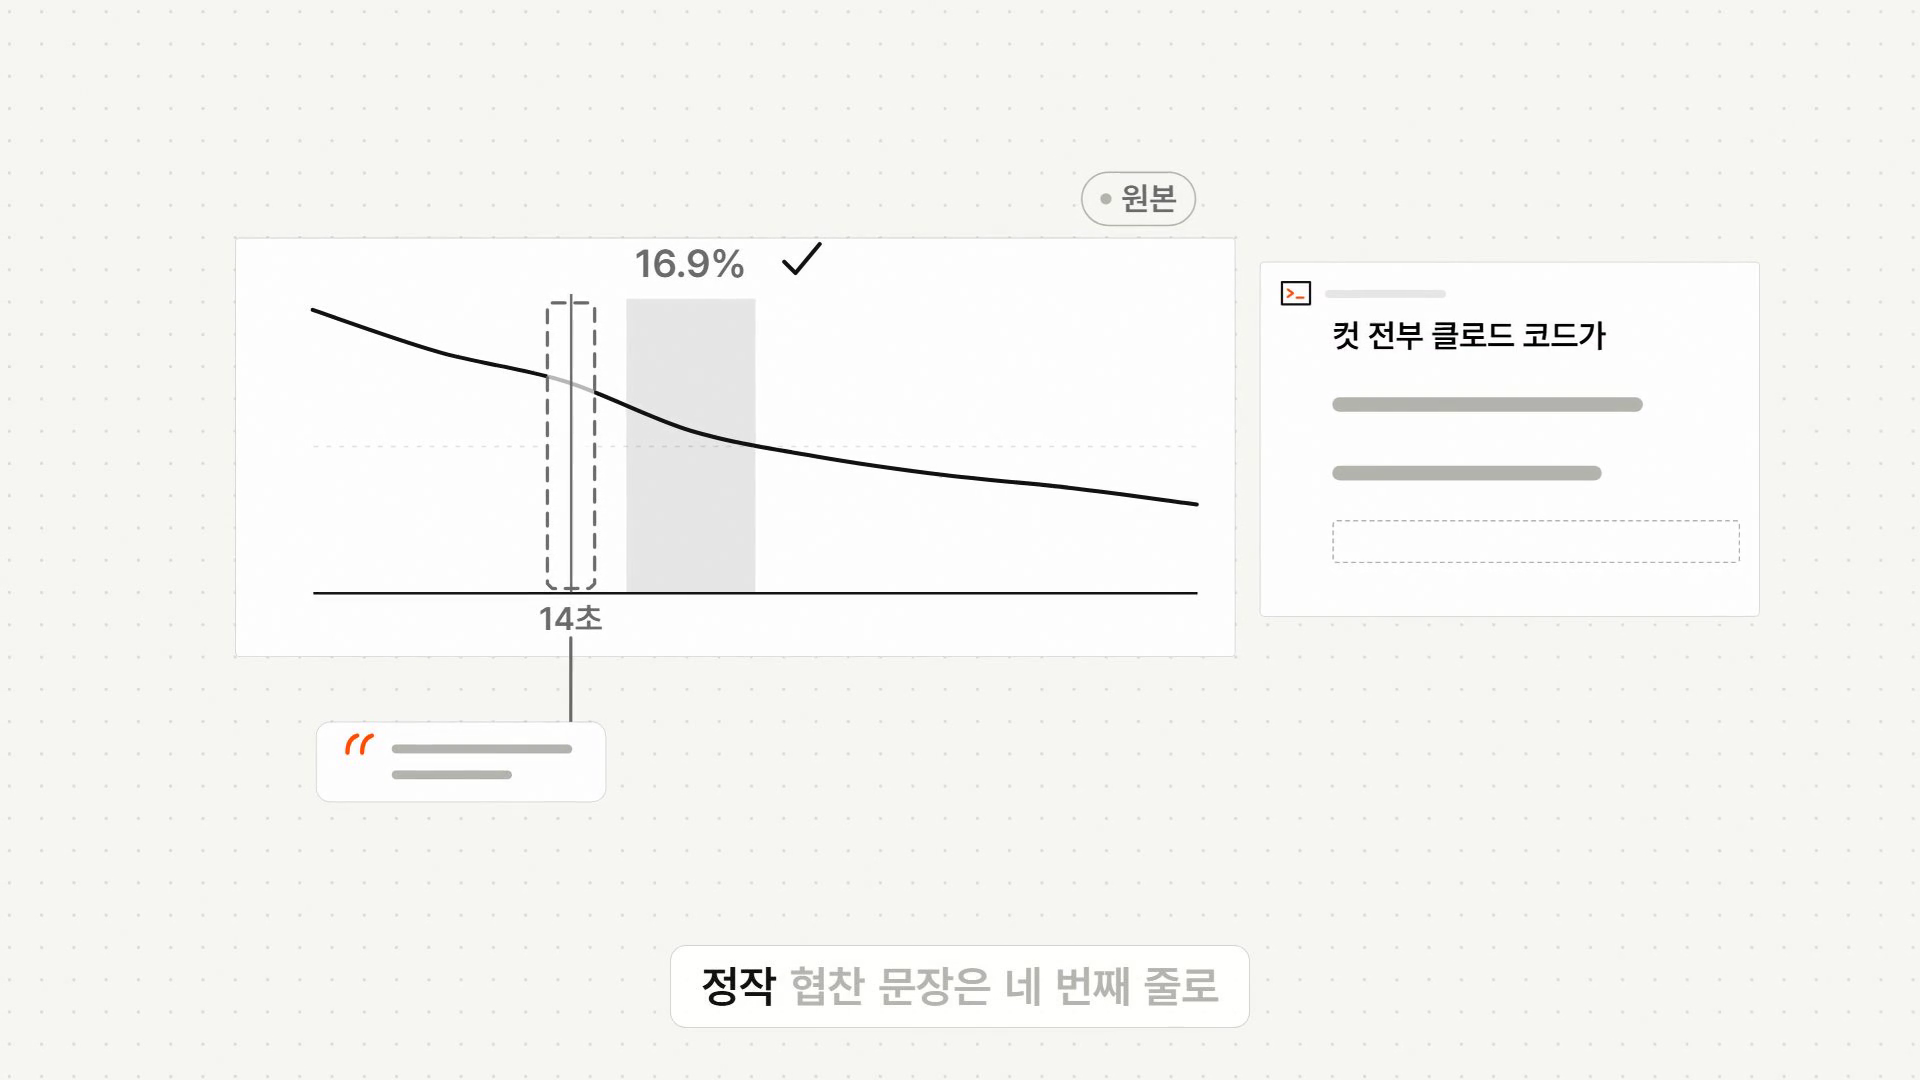
그 결과 원본이 붙인 대사는 앞 문장("컷 전부 클로드 코드가…")이었고, 정작 협찬 고지는 20초에 8.8% 빠진 별개의 작은 하락으로 네 번째 줄에 따로 잡혔습니다. 에러는 없었어요. 결과만 틀렸습니다.
구간 가운데로 맞추면 협찬 문장이 맨 위로 온다
한국어판은 표 파일 값이든 통계 창구 값이든 구간 가운데를 시각으로 잡습니다. 그러면 가장 큰 하락이 0:17~0:24로 찍히고, 18.9초에 시작한 협찬 고지 문장이 첫 줄에 붙어요. 30초 시점에 남아 있던 사람은 47%였습니다.
같은 하락을 두고 원본은 앞 문장을, 한국어판은 실제로 그 구간에 나온 문장을 보여 준 셈이에요. 그래서 꺾인 시각은 위치 값이 아니라 구간 가운데로 읽는 게 맞습니다.
77편에 돌리면 구멍은 거의 첫 30초에 있다
시각을 맞춘 도구를 제 롱폼 77편에 전부 돌렸습니다. 77편 중 75편은 가장 큰 구멍이 첫 30초 안에 있었어요. 첫 30초에 빠지는 비율의 가운데 값은 37%p, 들어온 사람 셋 중 한 명꼴입니다.
중반은 1분에 3%p 남짓씩 빠졌어요. 첫 30초가 대본에서 가장 먼저 손볼 곳이라는 뜻이고, 그래서 다음 도구가 첫 문장 채점기입니다.
영어 낱말로 매긴 점수는 한국어 첫 문장을 구분하지 못한다
원본 첫 문장 채점기는 영어 단어 명단을 기준으로 점수를 매깁니다. '너'·'잃다'·'왜'에 해당하는 영어 낱말이 있으면 오르는 식이에요. 한국어 문장에는 그 낱말이 없으니 어떤 문장을 넣어도 비슷한 점수가 나옵니다.
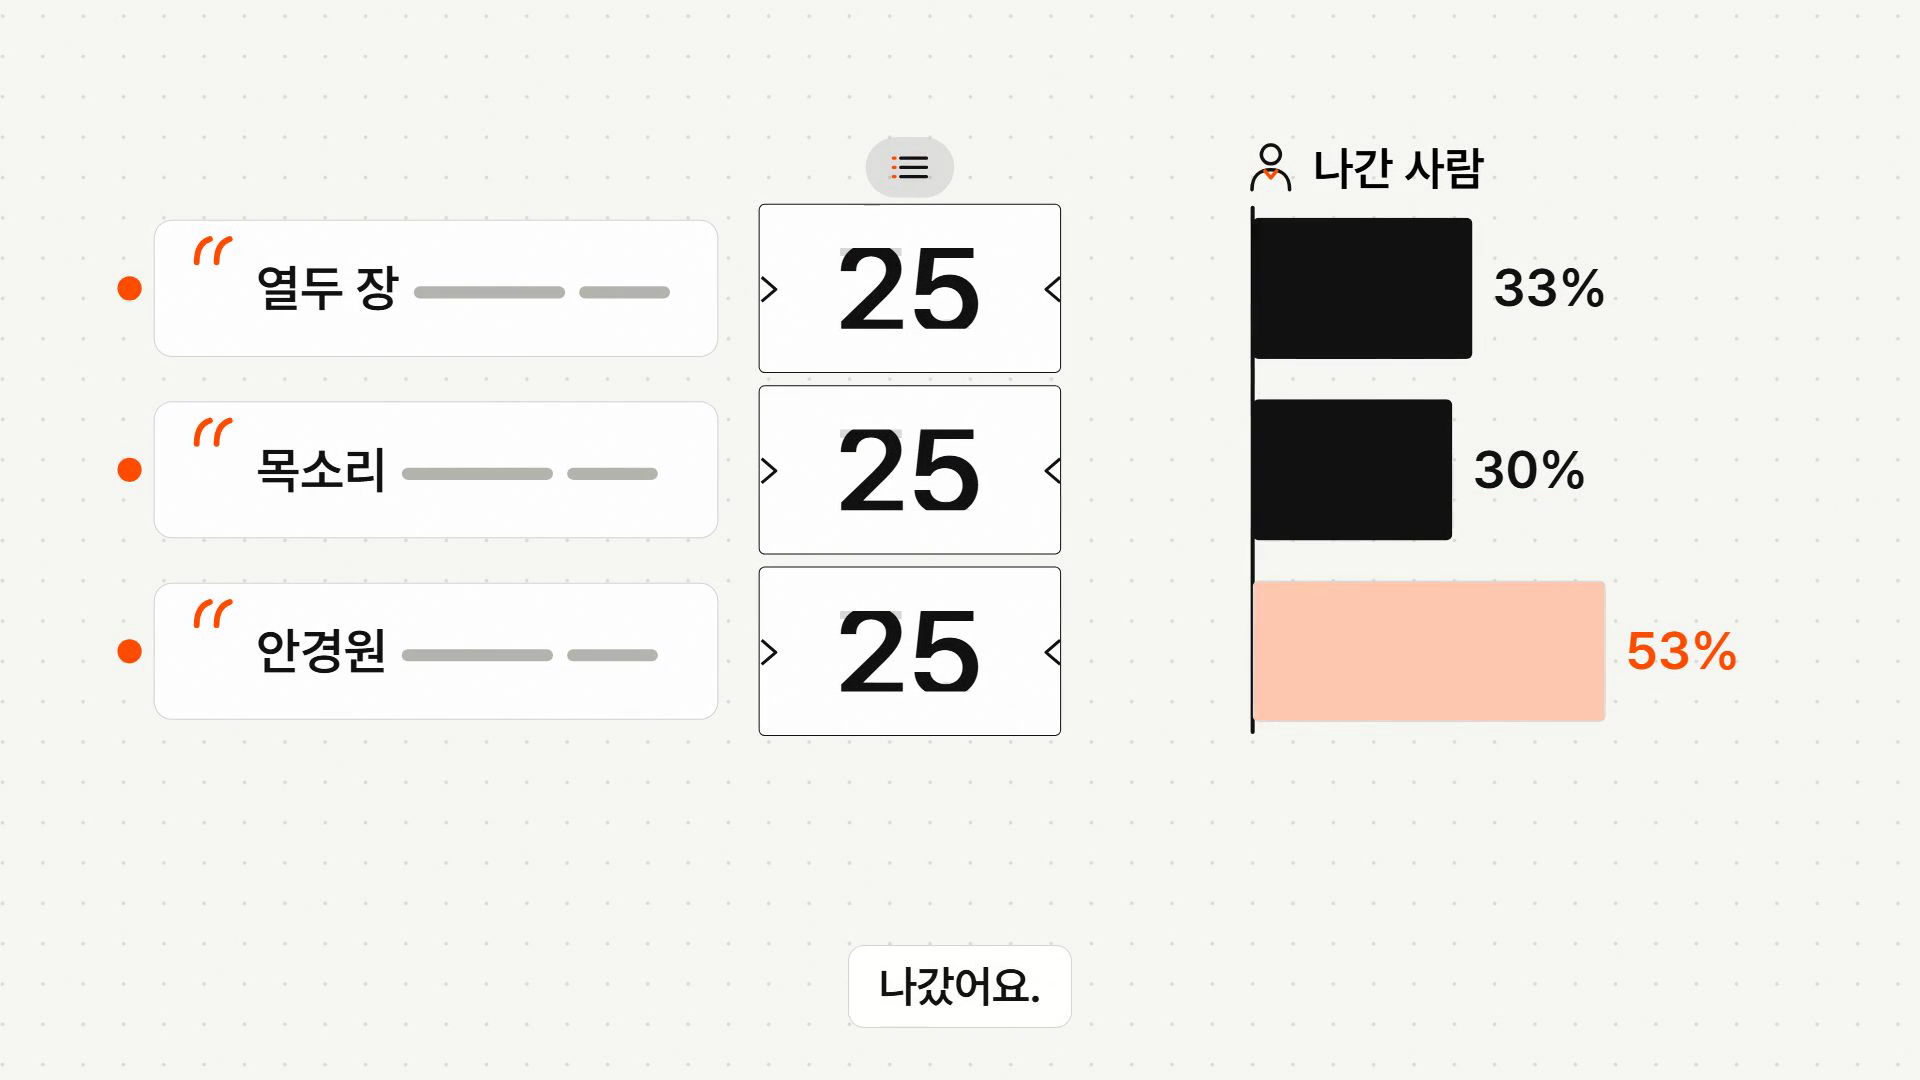
제 첫 문장 셋에는 모두 25점(약함)이 나왔어요. 30초 안에 빠진 비율은 33%·30%·53%로 크게 달랐습니다. 절반 넘게 나간 문장과 가장 잘된 문장이 같은 점수를 받은 거예요.
신호를 한국어로 바꾸면 100·65·15로 벌어진다
한국어판은 점수 신호를 한국어 대본에서 실제로 작동하는 것으로 바꿨습니다.
| 더하는 신호 | 빼는 신호 |
|---|---|
| 화면을 가리키는 말("지금 이 열두 장") | 대상 호명("사장님") |
| 실제로 한 일 | "끝까지 보시면" 같은 예고 |
| 기대를 꺾는 말 | 막연한 전제로 시작 |
| 구체 숫자 | 45자를 넘는 첫 문장 |
같은 세 문장이 100점, 65점, 15점이 됐어요. 15점을 받은 문장이 실제로 53%가 나간 문장입니다.
하지만 이 점수로 조회수를 맞힐 수는 없었다
점수가 이 정도로 벌어지면 영상 성적까지 미리 알 수 있을 것처럼 보입니다. 그래서 77편 각각의 앞부분 15초 자막을 양쪽 채점기에 넣고, 점수 순위와 30초 이탈 순위의 상관을 계산했어요.
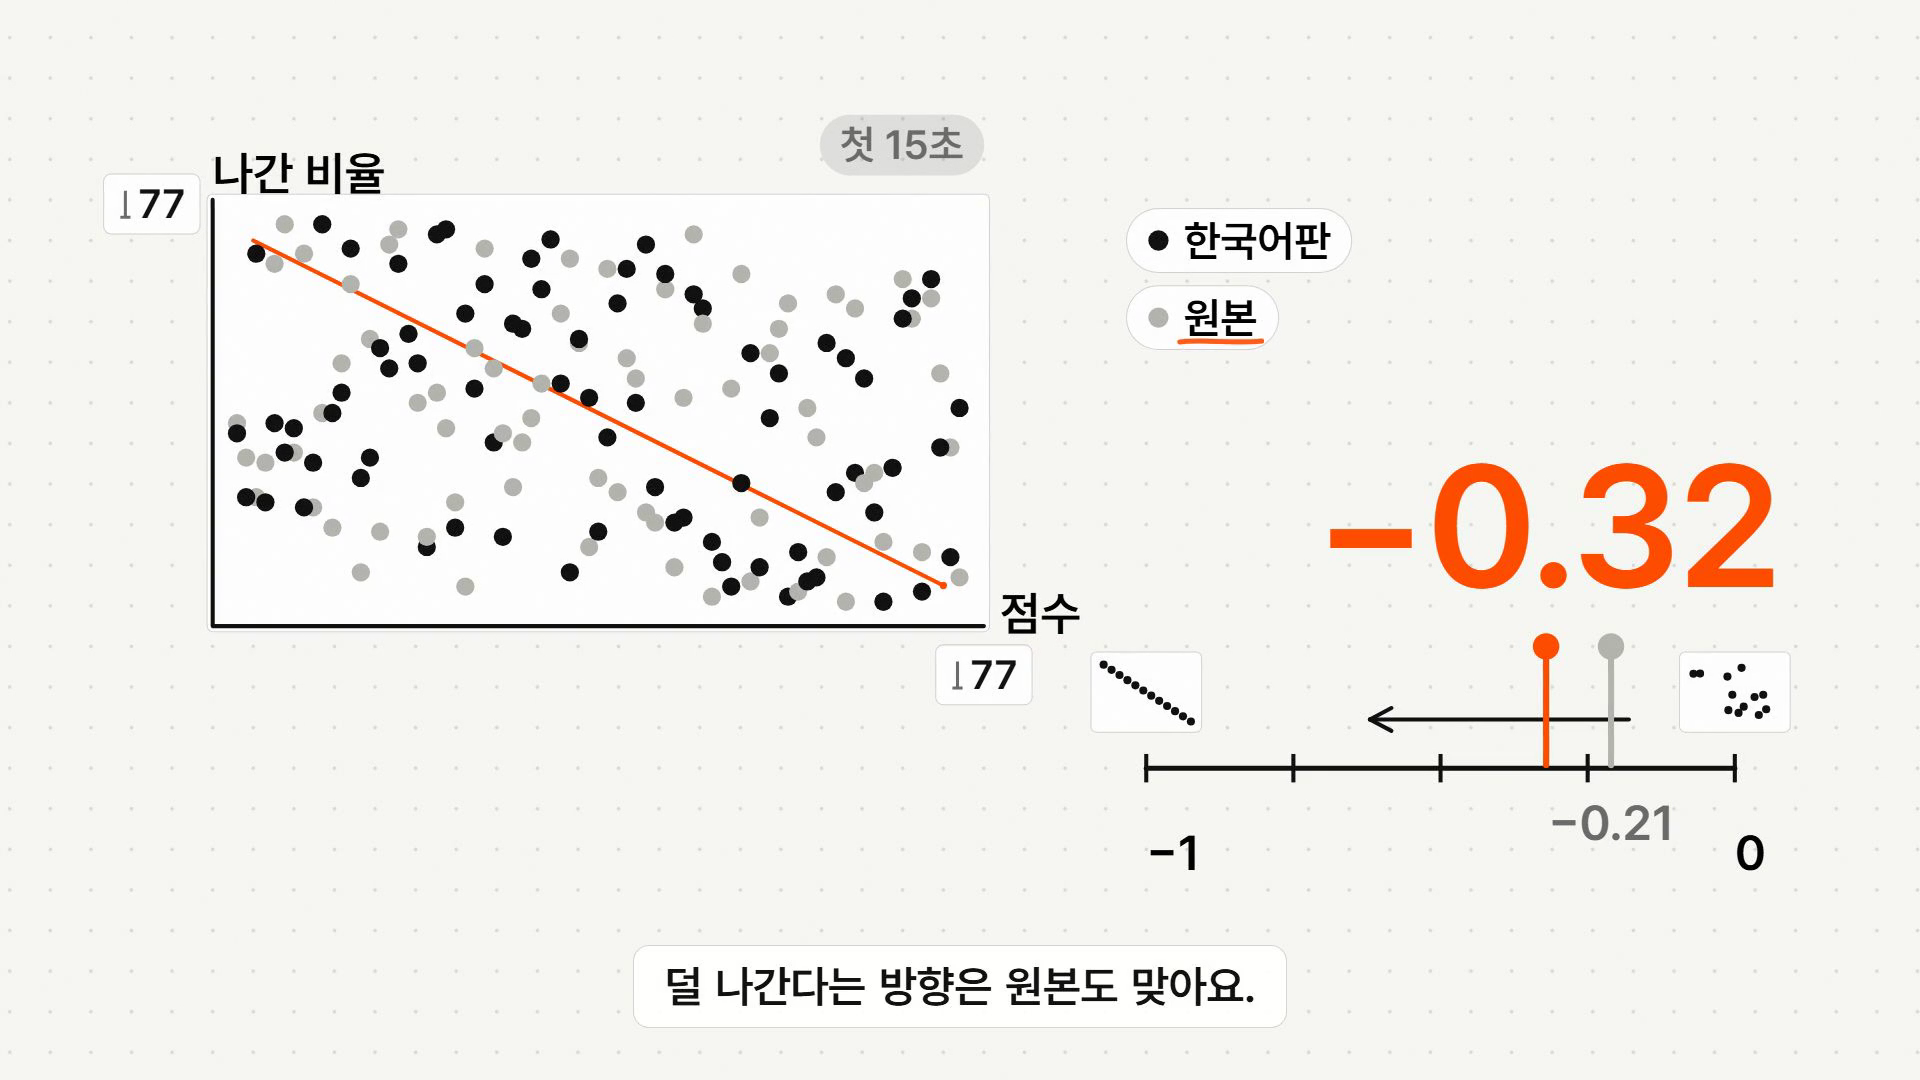
한국어판 -0.32, 원본 -0.21이었습니다. 0이면 상관없음이고, -1에 가까울수록 점수 높은 첫 문장에서 덜 빠진다는 의미입니다. 방향은 원본도 맞았지만, 한국어판도 기대와 달리 힘이 약했습니다. 신호를 같은 채널 자료에서 뽑았으니 실제보다 좋게 나왔을 가능성도 있어요.
그래서 이 점수는 예측기가 아니라 손볼 첫 문장을 짚어 주는 대략적인 점수로만 씁니다. 첫 문장을 세 개 써 놓고 가장 낮은 것부터 지우는 데까지만 씁니다.
글자 수가 아니라 글자 폭이 제목을 자른다
원본 제목 검사기는 60자·40자라는 글자 수로 잽니다. 영어 제목에 맞춘 숫자라, 한국어 제목을 넣으면 "AI"를 대문자 강조어로 세고 "2.5"를 숫자 근거로 쳐 주는 식으로 엉뚱한 걸 집었어요.
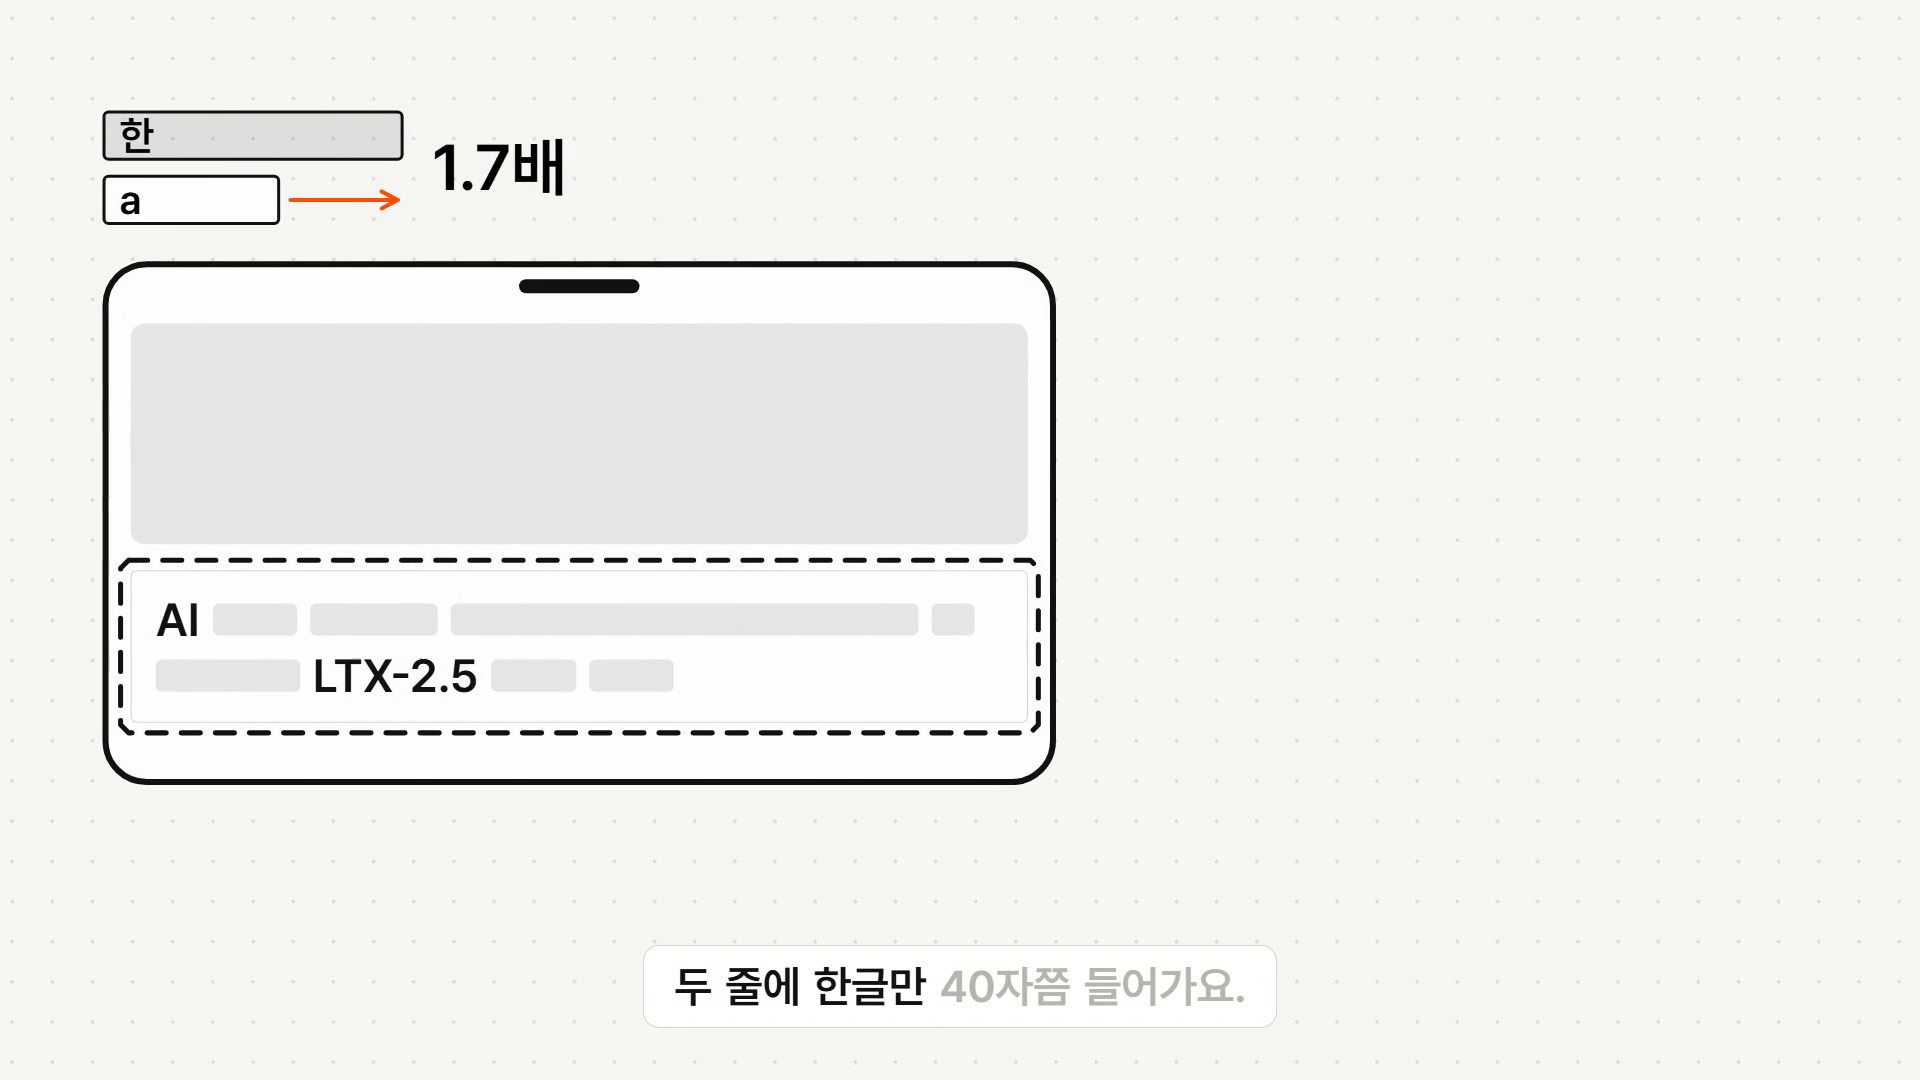
그래서 유튜브 화면에서 글자 폭을 직접 쟀습니다. 한글 한 글자는 12.88픽셀, 영어 소문자는 7.62픽셀이라 폭 차이가 1.7배쯤 됩니다. 휴대폰 검색·홈의 제목 폭(263픽셀 두 줄)에는 한글 기준 약 40자, PC 홈에는 약 44자가 들어갑니다. 글꼴이 기기마다 달라 오차가 몇 글자 있습니다. 이 기준으로 경쟁 채널 제목 300개를 재면 77개가 휴대폰에서 잘렸습니다.
제목 공식으로는 뜬 영상의 이유가 거의 설명되지 않는다
떡상 영상 찾기에서 채널별 평소 조회수 대비 배수로 순위를 매기는 부분은 원본 그대로 잘 됐습니다. 경쟁 채널 38개 981편 중 평소의 3배를 넘긴 영상이 191편이었어요.
틀어진 건 그다음, 영어 제목 공식에 맞춰 묶는 단계예요. 여기서 155편이 "분류 안 됨"으로 빠졌습니다. 한국어 제목 신호로 다시 재 보니, 뜬 영상과 전체의 차이가 가장 큰 신호가 챗GPT·OpenAI 언급으로 1.8배였고 나머지는 거의 1배 안팎이었습니다. 제목만으로는 왜 떴는지 거의 설명되지 않는다는 결과예요.
고칠 필요가 없던 세 가지는 글자를 세지 않는다
고칠 필요가 없던 건 답글 쓰기, 설명란, 한 주 계획 세 가지입니다. 원본에 댓글 40개, 자막, 채널 현황 자료를 그대로 넣어 봐도 한국어판과 결과가 같았고, 고정 댓글 선택과 중심 영상 선택까지 일치했어요.
공통점을 보면 이 셋은 영어 낱말 목록이나 글자 수를 세는 파이썬 도구를 쓰지 않습니다. 클로드가 직접 읽고 쓰는 일이라 언어가 바뀌어도 그대로 돌았어요. 반대로 틀어진 여덟은 전부 영어 낱말을 세거나, 영어 기준 숫자를 쓰거나, 그런 채점기를 안에서 불러 쓰는 스킬이었습니다. 제가 보기엔 영어 스킬을 한국어에 쓸 때 먼저 볼 건 스킬 이름이 아니라 속에 낱말·글자 수를 세는 파이썬 도구가 들어 있느냐예요.
내 채널 자료로 먼저 확인할 세 가지
위에서 본 어긋남이 셋이니 확인도 셋입니다.
- 꺾인 시각 — 리텐션 결과 맨 위 줄의 시각에 영상을 직접 틀어, 붙은 대사가 실제로 그때 나오는지 봅니다. 몇 초 앞 문장이 붙었다면 위치 값을 그대로 쓴 겁니다.
- 첫 문장 점수 — 내 첫 문장 세 개를 넣어 점수가 벌어지는지 봅니다. 셋이 비슷하면 영어 단어 기준으로 매겨지고 있다는 신호예요.
- 제목 폭 — 글자 수가 아니라 휴대폰 두 줄 폭 기준으로 핵심어가 잘리는 데보다 앞에 있는지 봅니다.
제 협찬 편은 이 첫 번째 확인으로 17명꼴이 빠진 7초와 협찬 고지가 겹친다는 데까지 확인했습니다. 이 문장이 원인인지는 따로 검증해야 해요. 내 최근 영상은 몇 초에서 가장 많이 빠졌나요? 한국어판 11개 묶음(고친 8개 + 원본 3개)은 방구석모각코 오픈채팅방에 공지로 올려 뒀고, 「클로드 스킬 추천|내 유튜브 77편, 사람들이 나간 대사까지 찾았습니다」 영상은 상단에서 바로 볼 수 있어요.