조회수로 콘텐츠 주제를 고르면 안 되는 통계적 이유
유튜브 조회수는 평균 5,868회·중앙값 35회로 극단적 우편향 분포다. 주제 판정에 절대 조회수를 쓰면 채널 규모가 섞여 들어가는 구조적 이유와, 판정기를 어떻게 설계했는지 정리했다.
방구석컴퍼니
혼자 일하는 사람 · 작업 기록
주제를 고르려고 잘 되는 채널 목록을 열어두고 30분을 스크롤한 적이 있다. 하나도 못 골랐다. 감이 없어서가 아니라 정렬 기준이 틀려 있었다. 조회수는 단일 지표처럼 보이지만 실제로는 두 개의 서로 다른 변수를 합산한 값이다. 이 글은 그 구조와, 판정을 자동화하면서 어떤 규칙을 넣었는지를 다룬다. 따라 하는 절차가 아니라 설계 근거다.
콘텐츠 주제를 데이터로 고르려다 목록 앞에서 막히는 사람을 위한 글이다.
조회수가 합성 지표인 이유
조회수 한 숫자에는 주제의 흡인력과 채널의 기존 도달력이 함께 들어간다. 구독자 6만 채널의 평작과 구독자 2천 채널의 히트작이 같은 1만 회를 기록할 수 있다. 정렬은 이 둘을 구분하지 않으므로, 목록 상단은 구조적으로 큰 채널에 점유된다.
판정에 쓰려면 채널 규모 성분을 제거해야 한다. 표준적인 방법은 관측값을 해당 채널의 기준선으로 나누는 것이다. 나눗셈 한 번으로 규모가 상쇄되고 남는 것이 주제 성분이다.
기준선에 평균을 쓰면 안 되는 이유
유튜브 전체 영상의 조회수 분포는 극단적 우편향이다.
| 통계량 | 값 |
|---|---|
| 평균 | 5,868회 |
| 중앙값 | 35회 |
| 비율 | 약 168배 |
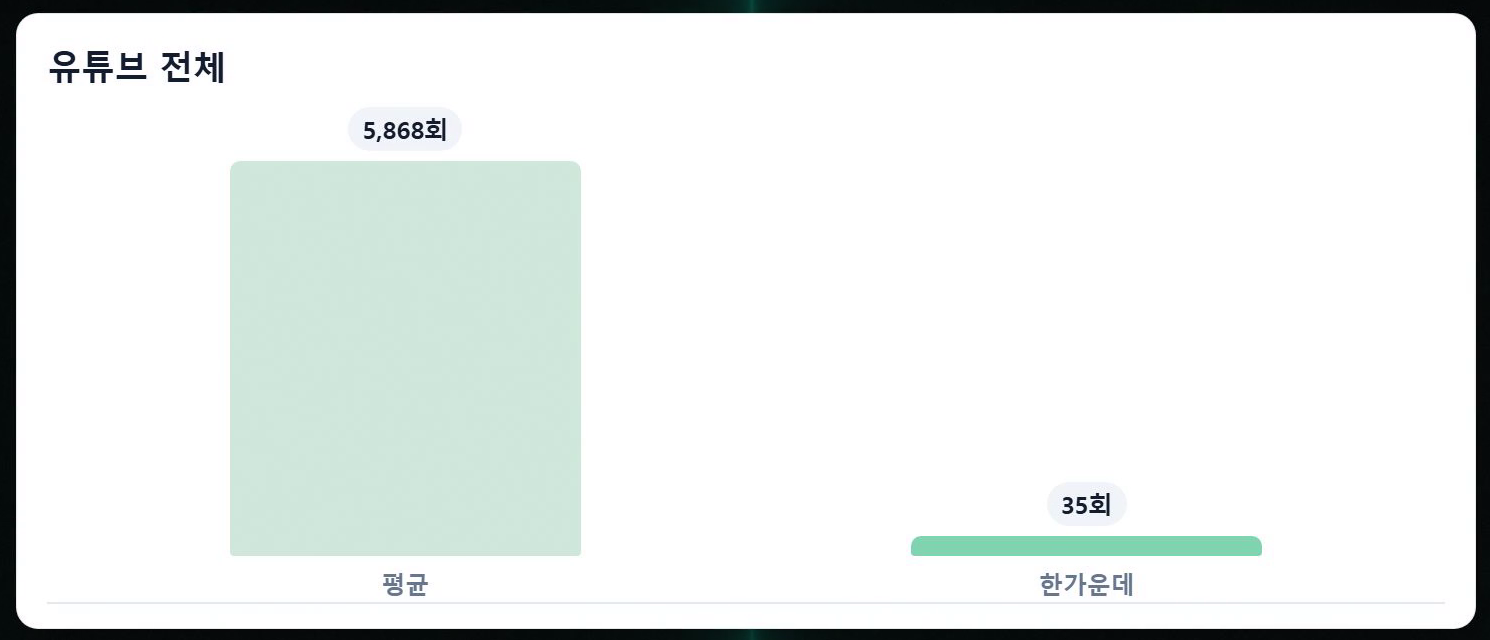
약 100억 개 영상 표본을 다룬 2023년 "Dialing for Videos" 연구의 수치다. 같은 연구에서 조회수 1,000회 미만이 전체의 86.93%, 1만 회 이상은 3.67%인데 이들이 전체 조회수의 93.61%를 가져간다.
이런 분포에서 평균은 소수의 극단값에 끌려간다. 채널 단위에서도 같은 일이 벌어진다. 최근 10개 중 히트작이 하나 섞이면 평균 기준선이 부풀어 그 채널의 통상 성과가 가려진다. 그래서 기준선은 중앙값을 쓴다.
업계 도구들이 같은 축을 쓴다
이 접근은 자체 발명이 아니다. 서로 다른 회사가 동일한 축을 채택했다.
| 도구 | 기준선 | 구간 |
|---|---|---|
| vidIQ | 채널 평균 | 2배 미만 / 2 |
| ViewStats | 직전 10개 업로드 평균 | 롤링 |
| OutlierKit | 채널 평균 | 3배 이상 유의미 |
수렴이 곧 정답을 뜻하지는 않지만, 축 자체가 업계 표준이라는 사실은 설계 근거로 쓸 만하다.
배수 단독으로는 판정이 안 되는 이유
배수가 크면 좋은 주제라는 추론에는 빈틈이 있다. 큰 배수는 "그 채널의 통상값과 그 영상의 차이가 컸다"만 말한다. 원인은 주제일 수도, 그날의 외부 사건일 수도 있다.
실제 하루치 실행에서 최댓값은 94.6배였다. 같은 주제가 다른 채널에 없었고 최신도 아니었다. 반면 통과한 후보는 8.34배였고 세 가지 조건이 함께 켜져 있었다. 낮은 값이 통과하고 높은 값이 탈락하는 상황이 실제로 발생한다.
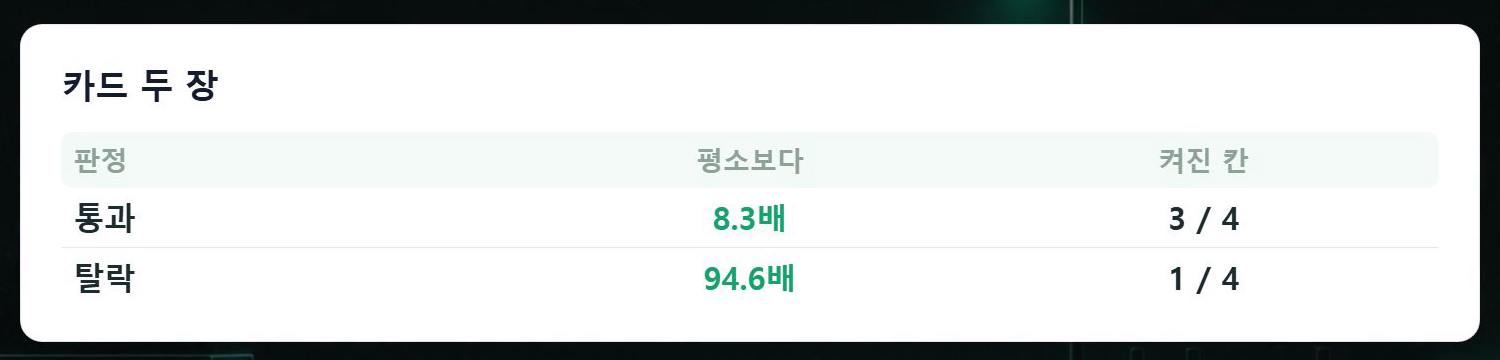
그래서 단일 임계값 대신 다중 신호 합의로 설계했다.
| 신호 | 판정 내용 |
|---|---|
| 배수 | 채널 중앙값 대비 진입선 2.5배, 발동선 8.0배 |
| 교차 채널 | 서로 다른 채널 2곳 이상에서 독립 관측 |
| 신선도 | 최근 구간 내 발생 |
| 패키징 | 제목·썸네일 반응 |
채택 조건은 배수 필수 + 나머지 중 2개 이상 합의다. 94.6배 후보는 배수 하나만 켜져 탈락했다.
표본이 적으면 판정하지 않는다
기준선 최소 표본을 10개로 두고, 미달이면 판정 자체를 하지 않는다. 표본 34개짜리 채널에서 나온 배수는 노이즈에 가깝기 때문이다. ViewStats가 직전 10개, ChannelCrawler가 최근 1050개를 권장하는 것과 같은 계열의 선택이다.
실행 결과가 알려준 것
하루치 실행에서 채널 24곳을 대상으로 통상값을 넘어선 관측이 150건 수집됐다. 이 중 95건이 탈락하고 32건이 후보로 남았다. 그중 신뢰도가 높은 것은 2건이었고 나머지 30건은 관측이 한두 번뿐이었다.
처음에는 설계 실패로 봤다. 지금은 이것이 정상 출력이라고 본다. 하루치에서 근거가 튼튼한 후보가 두 개 나오면 충분하다. 판정기의 가치는 후보를 많이 만드는 게 아니라 대부분을 걸러내는 데 있다.
한계
- 효과가 검증되지 않았다. 이 규칙으로 선택한 주제의 성과 기록은 아직 비어 있다. 판정 설계이지 성과 주장이 아니다.
- 임계값에 이론적 근거가 없다. 2.5배·8.0배는 업계 구간 사이에서 고른 값이다. 왜 하필 그 값인지는 실측으로 답해야 한다.
- 패키징 신호가 약하다. 제목·썸네일 반응은 외부에서 관측하기 어려워 실제로는 거의 켜지지 않는다.
- 관측값 자체가 시점 의존적이다. 같은 후보를 다른 날 측정하면 결과가 달라진다.
발행 전 기준을 고정하는 이유
결과를 본 뒤에 성공 기준을 정하면 어떤 결과에도 설명이 붙는다. 500회면 초반이라서, 200회면 주제가 좁아서. 두 설명 모두 성립하므로 다음에 무엇을 바꿔야 할지는 알 수 없다.
과학계에서는 같은 문제를 HARKing으로 부르고, 처방은 데이터 수집 전에 가설과 기준을 문서로 고정하는 것이다. 이 영상에도 발행 전에 기준을 적어뒀다. 비교 대상은 전체 평균이 아니라 같은 성격의 자료 배포 영상 3편의 중앙값 928회이고, 그 두 배인 1,900회를 28일 기준으로 잡았다.
전체 롱폼 중앙값(149회)을 썼다면 통과가 거의 확실했다. 넘길 게 뻔한 기준은 사후 합리화를 막지 못한다.
정리
주제 판정에서 조회수를 그대로 쓰면 채널 규모가 섞여 들어간다. 채널 중앙값으로 나눠 규모를 제거하고, 배수 단독이 아니라 여러 신호의 합의로 채택하며, 표본이 모자라면 판정을 보류한다. 그리고 결과를 보기 전에 성공 기준을 고정한다.
같은 문제를 다른 방식으로 푸신 분이 있다면 어떤 축을 쓰셨는지 궁금하다.