Lost in the Middle 실측, 글자로 넣은 180번과 PDF로 올린 89쪽이 다른 답을 냈다
Lost in the Middle은 가운데를 놓친다고 했지만, 클로드에 글자로 넣은 180번은 위치와 상관없이 모두 맞혔습니다. 같은 문서를 89쪽 PDF로 제미나이에 올리자 끝 쪽 80쪽 문장을 7번 다 놓쳤습니다. 둘을 나눈 구조와 근거를 정리했습니다.
방구석컴퍼니
혼자 일하는 사람 · 작업 기록
"문서의 마지막 페이지"
맨 마지막 문장을 묻는 제 질문에 제미나이가 이렇게 적으며 댄 문장은 75쪽에 있었습니다. 제가 올린 파일은 89쪽이었고요. 같은 파일의 80쪽 문장은 7회 질문에 한 번도 찾지 못했어요.
이상한 건 같은 내용을 글자로 클로드에 직접 넣었을 때였어요. 위치와 길이를 바꿔 가며 180번 물었는데 180번 모두 맞혔습니다. 결론부터 말하면, 이번 법령 PDF 실험에서는 문서 속 위치만으로 결과를 설명할 수 없었고 서비스가 파일을 모델에 넘기는 단계를 함께 의심해야 했습니다.
긴 문서를 AI에 넣을 때 가운데가 빠진다는 말을 듣고 막혔던 분께, 제가 10월 13일 하루 동안 직접 잰 기록을 두 단계로 나눠 풀어 보겠습니다.
가운데가 약하다는 말은 어디서 나왔나
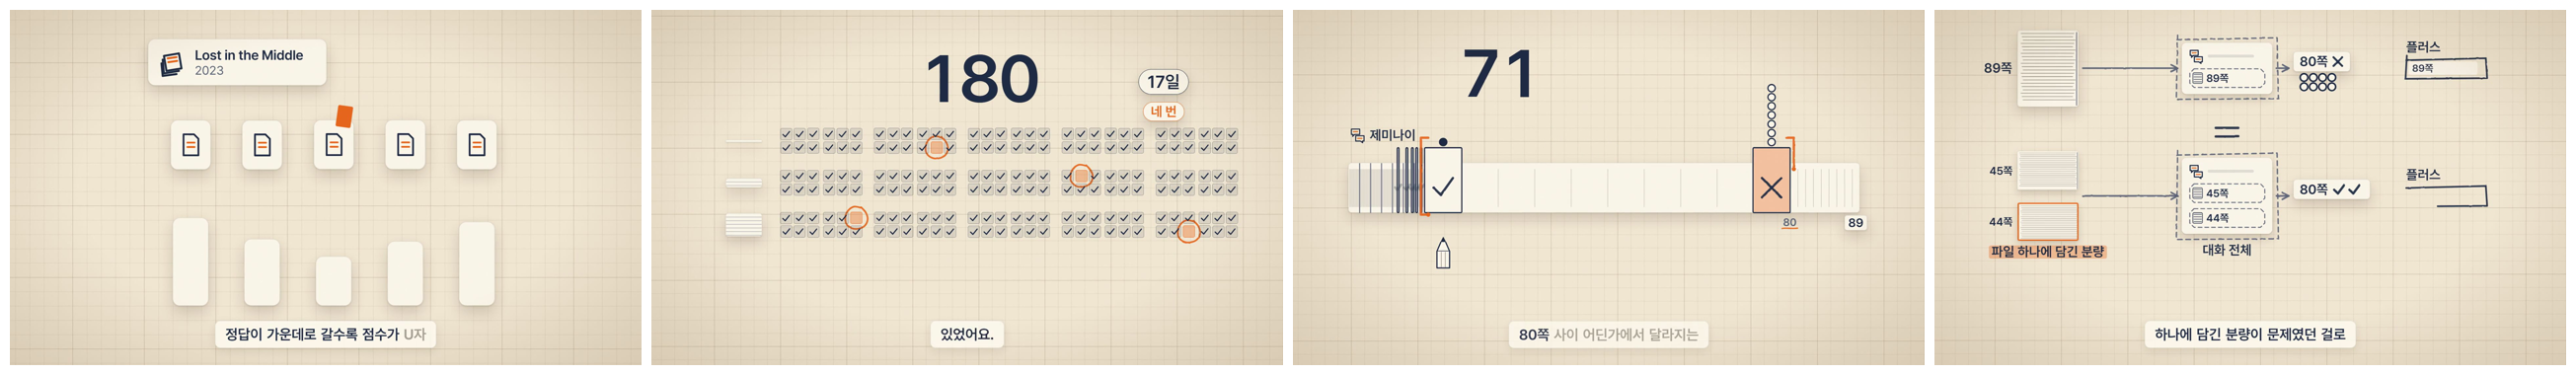
출처는 2023년에 나온 논문 「가운데서 길을 잃는다(Lost in the Middle)」입니다. 문서 10~30개 중 하나에만 정답을 넣고, 그 정답 문서의 위치를 바꿔 가며 물었어요.
정답이 맨 앞이나 맨 끝에 있을 때 점수가 가장 높고, 가운데로 갈수록 푹 꺼졌습니다. 그래프로 그리면 U자예요.
가장 눈에 띄는 숫자는 이겁니다. 당시 챗GPT에 쓰이던 모델은 문서를 아예 안 줬을 때 정답률이 56.1%였는데, 문서 20~30개를 주고 정답을 가운데 두면 그보다 낮았어요. 참고서를 펴 놓고 본 시험이 안 펴고 본 시험보다 못한 셈입니다.
다만 그 시험에서 문서 30개를 넣은 조건도 평균 약 4,400토큰이었습니다. 지금 서비스에 올리는 수십 쪽 PDF와는 규모가 다르니, 지금 모델에도 맞는지는 다시 재야 했어요.
지금 모델은 가운데를 놓칠까?
클로드에 글자로 직접 넣었을 때는 놓치지 않았습니다. 조항을 어디에 두든 정답률은 같았어요.
문서는 인공지능 기본법·개인정보 보호법 등 법령 다섯 개를 국가법령정보센터 원문으로 이어 붙였습니다. 앞에서부터 2만·8만·20만 자로 잘랐고, 20만 자가 원고지 약 1,000매예요. 여기에 진짜 법에 없는 조항을 하나 끼웠습니다.
제00조의2(인공지능 민원 답변 기한) 행정기관의 장은 인공지능을 활용한 민원 답변을 접수일부터 17일 이내에 하여야 한다.
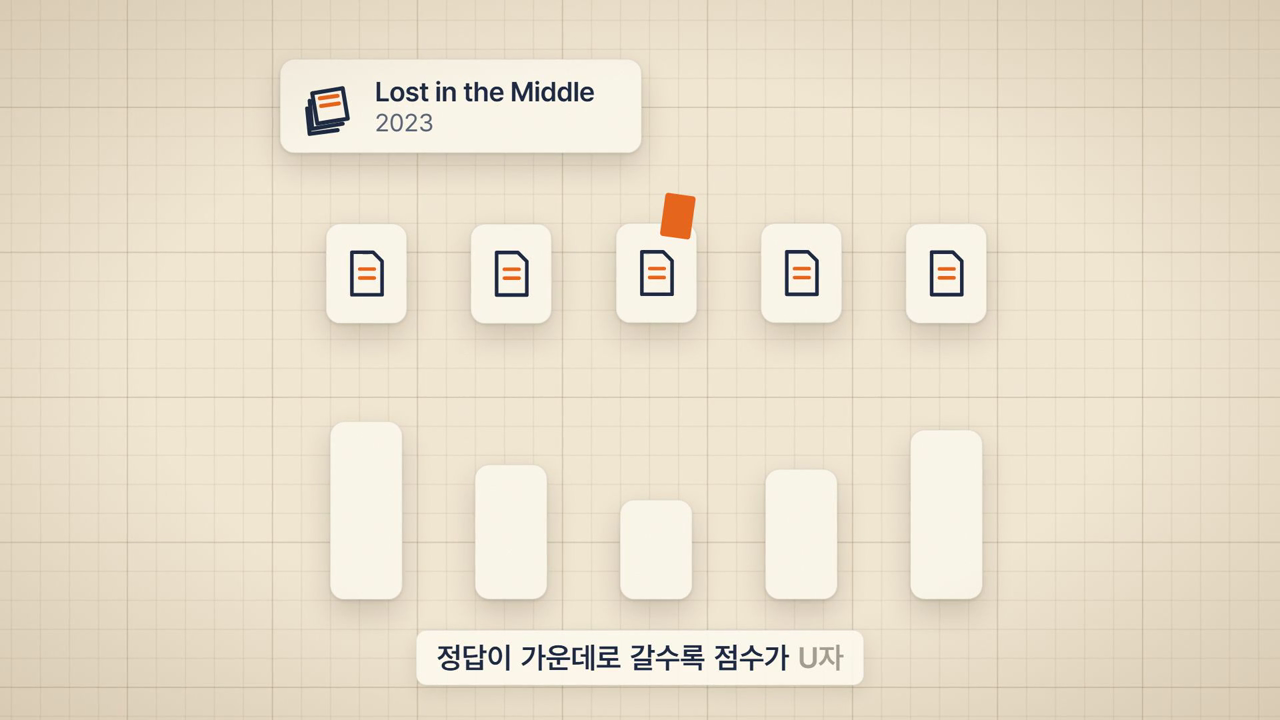
이 조항을 문서 앞에서 10·30·50·70·90% 위치로 옮기고, 클로드 소넷 5.5와 하이쿠 5.5에 채팅 앱을 거치지 않고 넣었습니다. 길이 3 × 위치 5 × 반복 3 × 질문 방식 2 × 모델 2로 180번이에요.
| 조건 | 결과 |
|---|---|
| 문서 낱말 그대로 물은 질문 | 90번 중 90번 |
| 낱말을 바꿔 돌려 물은 질문 | 90번 중 90번 |
| 비슷한 가짜 조항(14일)을 같이 넣음 | 45번 중 45번(위 합계에 포함) |
| 기한 조항 다섯 개를 한꺼번에 찾기 | 36번 모두 5개 다 찾음 |
같은 조건에서 비교하면 2만 자든 20만 자든, 10% 위치든 50% 위치든 차이가 없었습니다. 덤으로 하이쿠는 이 조항이 개인정보 보호법 중간에 임시 번호로 끼어 있으니 정식 조문인지 확인하라고 덧붙였어요.
그러니 "AI는 가운데를 못 읽는다"를 지금 모델에 그대로 옮기는 건 근거가 약합니다. 크로마라는 회사의 2025년 시험도 바늘 문장을 11개 위치로 옮겼을 때 위치 차이가 거의 없었다고 보고했어요.
하지만 처음 기록은 176번이었다
처음 표에는 180번 중 4번이 빈칸이었습니다. 저는 그걸 "길면 가끔 놓친다"로 읽을 뻔했어요.
원인은 제 설정이었습니다. 답 길이 한도를 200토큰으로 너무 작게 잡았는데, 모델이 답하기 전에 생각하는 데 그 한도를 다 써 버렸어요. 답안지를 백지로 낸 거죠. 앤트로픽 개발자 문서도 생각에 쓴 토큰이 답 길이 한도에서 빠진다고 적고 있습니다.
한도를 1,024로 늘려 같은 조건을 다시 물으니 네 번 모두 17일이었습니다. 다른 숫자를 댄 답은 처음부터 0번이었고요.
이 일로 순서 하나를 고쳤습니다. 틀린 답이 나오면 모델을 탓하기 전에 답이 비었는지, 다른 답인지부터 나눠 봅니다. 빈 답은 내 측정의 문제일 수 있으니까요.
같은 문서를 PDF로 웹에 올리면 무엇이 달라지나
여기까지는 글자를 모델에 바로 넣은 결과입니다. 챗GPT나 제미나이 웹에 PDF를 올리면 중간에 단계가 하나 더 생겨요. 서비스가 파일을 받아 손질해서 모델에 넘깁니다.
공식 문서에 적힌 손질 방식은 서비스마다 다릅니다.
- 챗GPT 도움말: 기업용이 아닌 요금제는 PDF 속 그림은 버리고 디지털 글자만 뽑습니다.
- 챗GPT 기업용 도움말: 문서 한 개가 11만 토큰을 넘으면 앞에서부터 11만 토큰만 통째로 넣고, 나머지는 검색용 목록으로 돌립니다. 개인 요금제의 처리 방식은 공식 문서에서 찾지 못했어요.
- 클로드 프로젝트: 한도에 가까워지면 필요한 부분만 찾아 넣는 방식으로 바뀌고, 그때 표시 아이콘이 뜹니다.
- 제미나이 앱: 큰 파일은 내용 사이의 연결이나 세부를 놓친 답이 나올 수 있다고만 적혀 있습니다.
그래서 웹에서 틀린 답은 두 가지로 나눠 봐야 합니다. 모델이 읽고도 놓친 건지, 서비스가 애초에 안 넘긴 건지요.
89쪽 PDF에서 제미나이는 어디까지 찾았나
20만 자 판을 89쪽 PDF로 만들어 두 서비스의 플러스 요금제 웹에 올렸습니다. 더 짧은 10쪽·37쪽 파일에선 12회 질문이 전부 정답이었어요.
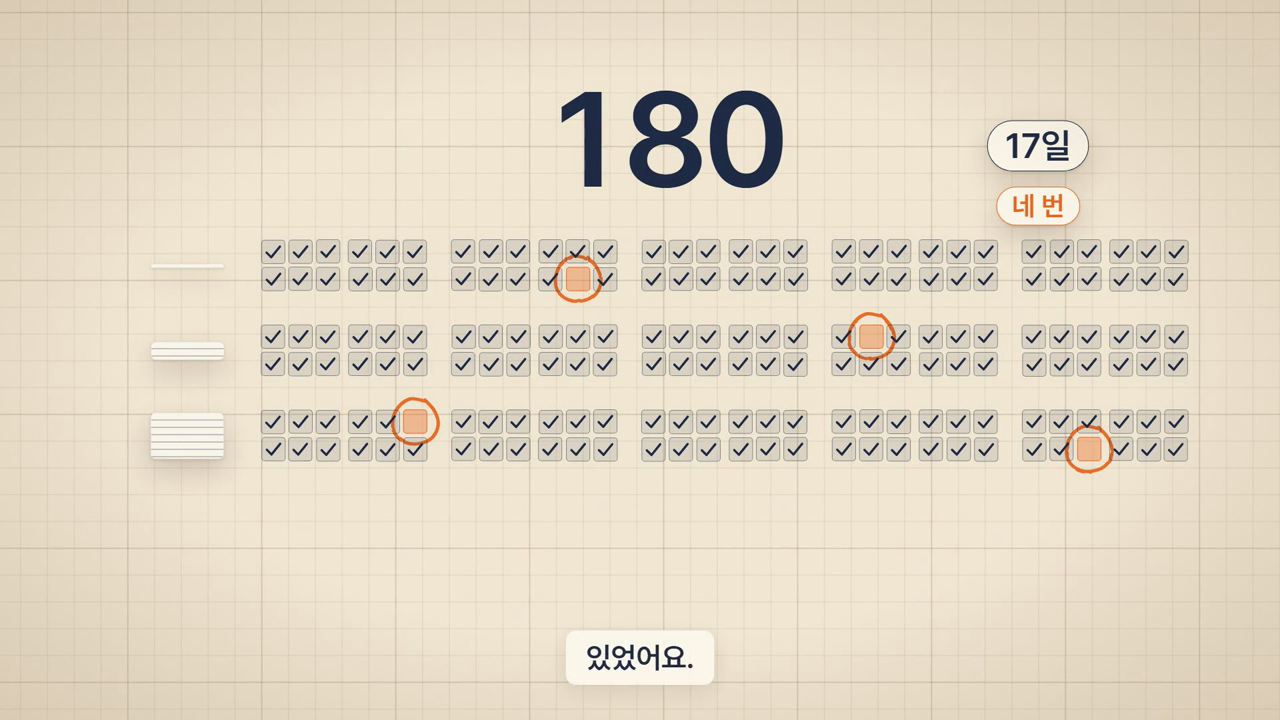
89쪽에서 결과가 나뉘었습니다. 제미나이는 46쪽(한가운데)은 찾고, 54·59·63·67·71쪽도 다 찾았습니다. 80쪽만 7번 물어 7번 다 놓쳤어요. 챗GPT는 같은 80쪽 문장을 3번 다 원문 그대로 옮겼습니다.
논문의 U자라면 한가운데가 가장 약해야 합니다. 제미나이는 반대로 가운데를 찾고 끝 쪽을 놓쳤어요. 앞에서부터 일정 분량까지만 들어가고 그 뒤가 빠진 모양에 더 가깝습니다.
모델을 바꿔도 같았던 이유
3.1 프로·최고가 모드로 바꾼 한 번의 시도도 80쪽에서 실패했습니다. 한 번에 읽는 양이 모델이 아니라 요금제에 묶여 있기 때문으로 보여요.
| 공식 한도(2026-10-13) | 제미나이 | 챗GPT(플러스 요금제) |
|---|---|---|
| 가장 작은 쪽 | 무료 3만 2천 토큰 | 빠른 모드 5만 4천 토큰 |
| 제가 쓴 쪽 | AI 플러스 12만 8천 토큰 | 생각하는 모드 25만 6천 토큰 |
| 가장 큰 쪽 | 프로·울트라 100만 토큰 | (플러스 안에선 위가 최대) |
| 89쪽 파일(약 20만 토큰)과 견주면 | 제가 쓴 요금제로는 넘침 | 제가 쓴 모드로는 들어감 |
표에서 볼 곳은 "제가 쓴 쪽" 줄입니다. 같은 파일이 한쪽 서비스에선 한도를 넘고, 다른 쪽에선 들어갔어요.
이 법령 문서에선 글자 수와 토큰 수가 거의 같았습니다. 다만 회사마다 토큰을 세는 법이 달라, 제미나이로 직접 센 값은 아니에요. 뒤쪽을 잘라 낸다는 공식 설명도 구글 문서엔 없습니다. 그래서 "한도를 넘어 뒤가 안 들어간 것으로 보인다"까지만 말할 수 있어요.
파일을 나누면 결과가 바뀌는가
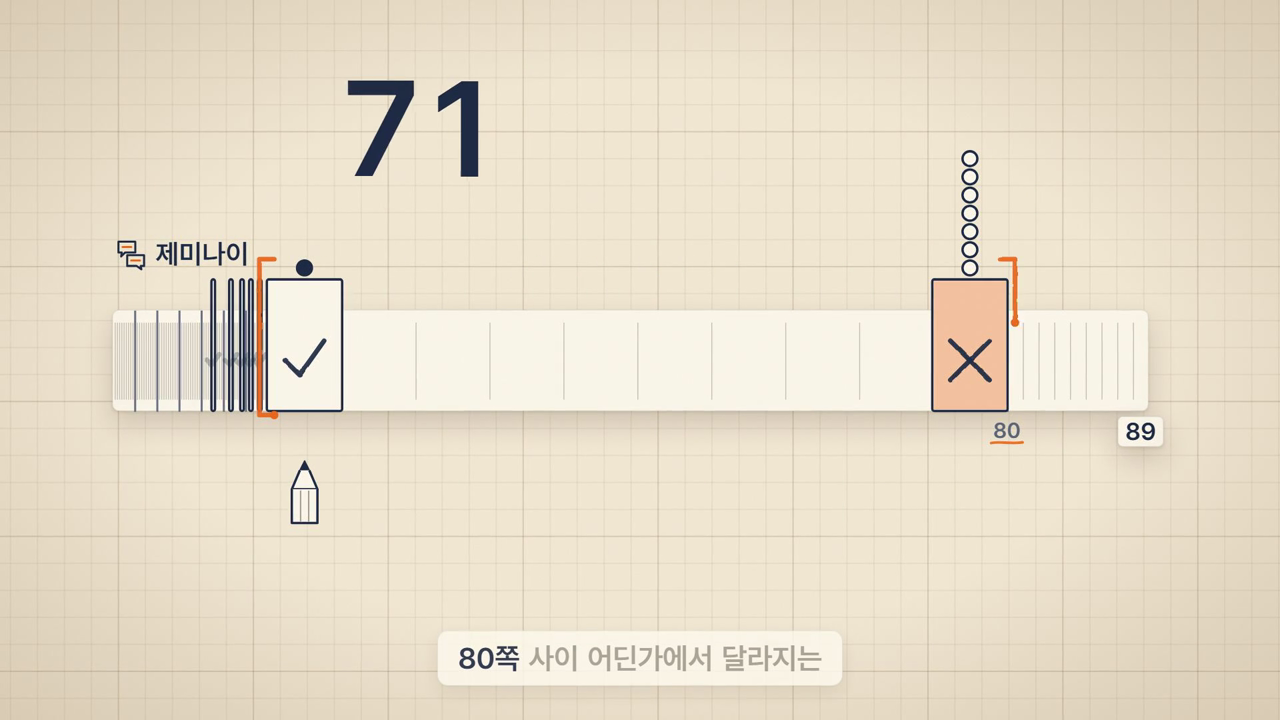
바뀌었습니다. 원본을 145쪽과 4689쪽으로 잘라 두 파일을 한 대화에 넣자, 2회 질문 모두 80쪽 조항이 나왔어요. 뒤 44쪽 파일만 올려도 2번 다 찾았습니다.
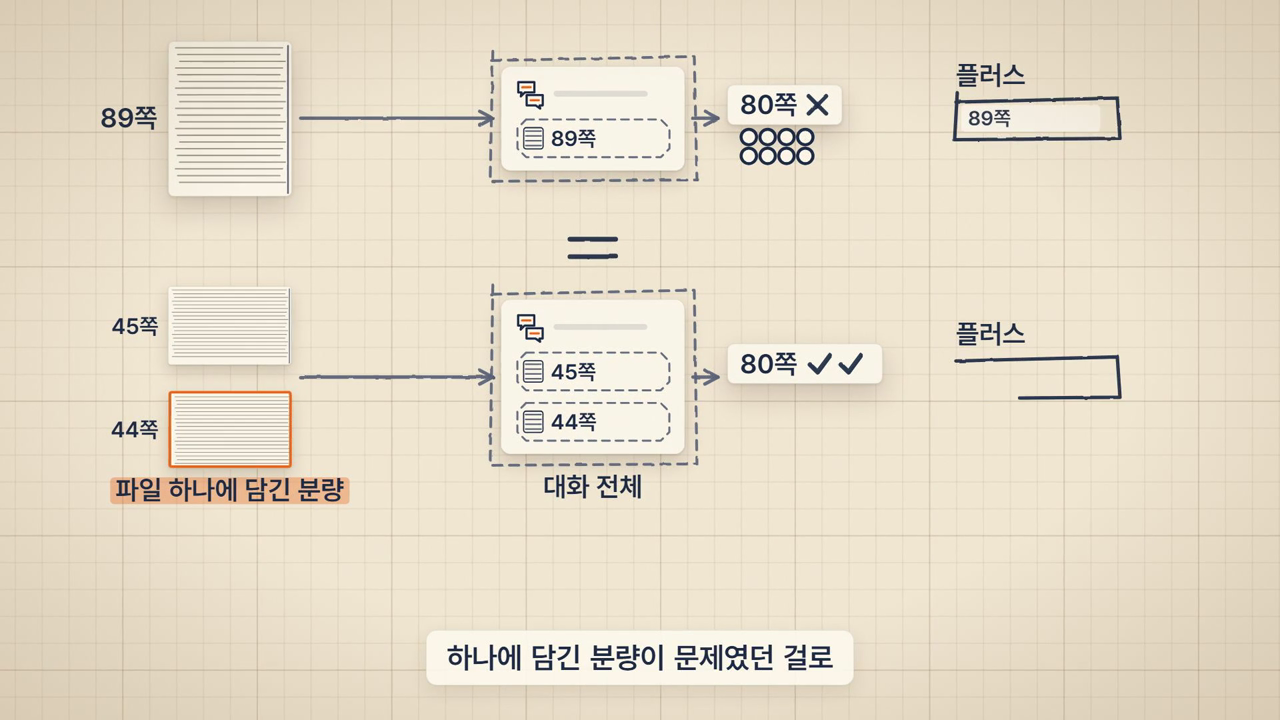
대화에 들어간 내용은 그대로인데 파일 한 개의 분량만 줄었습니다. 대화 전체 분량이 아니라 파일 하나에 담긴 분량이 결과를 정한 것으로 보여요. 자른 위치가 하나뿐이고 조건별 2회였다는 한계는 같이 적어 둡니다.
여러 개 찾기는 다른 조건에 묶였다
한 문장 찾기와 달리, 기한 조항 다섯 개를 한꺼번에 찾는 질문은 파일을 나누지 않고 모드를 바꿔서 풀렸습니다. 38쪽 파일(클로드 기준 약 8만 2천 토큰, 플러스 한도 안)에서도 제미나이 기본 모드의 성적은 네 번 모두 0개였어요. 두 번은 언어 모델이라 도와줄 수 없다며 거절했고요.
같은 파일로 3.1 프로에 한 번 물었을 땐 5개 전부 나왔습니다. 챗GPT는 38쪽·89쪽 모두 다섯 개를 다 찾았어요. 구글 도움말이 문서 곳곳에 흩어진 세부를 많이 챙겨야 하는 질문일수록 놓칠 수 있다고 쓴 경우가 이쪽입니다.
그래서 처방을 둘로 나눕니다. 한 문장이 안 나오면 파일을 줄이고, 여러 개 모으기가 안 되면 모드를 올립니다.
끝까지 들어갔는지 확인하는 질문
처음엔 "맨 마지막 문장이 뭐냐"고 물으면 확인되는 줄로 알았습니다. 틀렸어요. 제미나이가 마지막이라며 댄 쪽은 89쪽 파일에서 75쪽, 37쪽 파일에서 23쪽, 44쪽 파일에서 43쪽이었습니다. 37쪽·44쪽 파일은 끝 쪽 문장 찾기는 통과하던 파일이에요.
실측과 매번 맞은 건 반대 방향의 질문이었습니다. 마지막 몇 쪽에서 내가 이미 아는 문장을 골라, 답은 빼고 묻고, 근거가 된 문장을 문서 글자 그대로 붙여 달라고 하는 겁니다.
[끝 쪽 문장의 내용을 답 없이 바꾼 질문] — 첨부 문서 기준으로 답해 줘.
답의 근거 문장도 문서에 적힌 글자 그대로 붙여 줘.
정답에 끝 쪽 원문이 그대로 붙어 나오면 그 쪽까지는 모델에 전달됐다고 봐도 됩니다. 이 질문을 89쪽 한 파일에 쓰면 실패, 나눈 파일에 쓰면 통과로 나왔어요. 결과가 파일 분량과 매번 같은 방향으로 움직였습니다.
이 기록의 범위
측정은 서비스별 계정 하나, 하루 동안이었고 조건마다 1~7번 물었습니다. 표·그림이 없는 법령 글자 PDF 한 종류만 썼어요.
크로마의 2025년 연구는 질문과 정답 문장이 낱말을 덜 공유할수록 글이 길어질 때 점수가 더 떨어진다고 보고했습니다. 이 회사가 AI용 검색 도구를 판다는 점은 같이 봐야 하지만, 문서와 질문이 바뀌면 결과도 달라질 수 있다는 경고로는 유효해요. 제 실험의 "낱말 바꿔 묻기"는 한 가지 표현만 썼습니다.
두 단계로 나눠 보면
글자로 직접 넣으면 위치는 문제가 아니었고, 웹에 PDF로 올리면 파일 한 개의 분량과 요금제 한도가 끝 쪽을 갈랐습니다. 사례는 네 개, 처방도 네 개로 맞춥니다.
- 위치 걱정이 들면 → 내 문서를 글자로 넣었는지 파일로 올렸는지부터 구분하기
- 빈 답이 나오면 → 모델 탓 전에 답 길이 한도 같은 내 설정부터 보기
- 끝 쪽 문장을 못 찾으면 → 파일을 나눠 한 파일 분량 줄이기
- 여러 조항 모으기가 안 되면 → 모드를 올려 다시 묻기
규정집·계약서 같은 긴 글자 PDF를 올렸다면, 끝 쪽 문장 하나로 위 질문을 먼저 던져 보세요. 질문 틀과 PDF 나누는 법, 요금제별 한도표를 한 장으로 묶은 점검 카드는 오픈톡 '방구석모각코'의 공지글에 있고, 실험 과정은 위 영상에 담았습니다. 원문은 Lost in the Middle 논문, 제미나이 앱 도움말, 챗GPT 요금제 안내에서 확인할 수 있어요. 같은 문제를 검색 방식 쪽에서 본 검색 방식 6년이 남긴 설계 원칙도 함께 보시면 좋습니다.