로컬 음성 AI의 값어치는 무료가 아니라 주소 한 줄이다
오픈소스 음성 AI를 왜 오픈AI 호환으로 만들었는지, 그 설계가 무엇을 포기하고 무엇을 얻었는지 실측으로 뜯어봤습니다. 이식 비용과 재현성의 맞교환 기록.
방구석컴퍼니
혼자 일하는 사람 · 작업 기록
무료 음성 AI를 다루는 글은 이미 많습니다. 제가 훑은 상위 24편이 전부 "만들기"와 "복제하기"에서 끝났어요. 그런데 제가 이 도구를 계속 쓰게 된 이유는 그 둘이 아니었습니다.
설치에 17GB를 쓰고 7분을 기다렸는데, 정작 값어치는 그 뒤에 열리는 창구 하나에 있었습니다.
이 글은 그 창구가 왜 그렇게 설계됐는지, 그 설계가 무엇을 포기하고 무엇을 얻었는지를 봅니다. 설치 절차와 명령어는 다루지 않습니다.
오픈AI 음성 기능으로 자동화를 돌리다가 크레딧이나 한도에 막혀본 분이라면 이 글이 맞습니다.
무료라는 사실은 왜 선택 근거가 못 되는가
가격이 0이 되는 것만으로는 작업이 안 바뀝니다. 웹에서 무료로 쓰는 음성 도구는 이미 여럿 있으니까요.
실제로 바뀌는 건 호출 지점이 옮겨올 때입니다. 예전 제 작업 순서는 복사 → 사이트 → 붙여넣기 → 내려받기였습니다. 지금은 그 네 단계가 통째로 사라졌어요. 사라진 건 요금이 아니라 작업이 끊기는 횟수입니다.
그래서 이 도구를 재는 기준도 가격이 아니라 "내 파이프라인 안으로 들어오는가"가 되어야 합니다.
목소리 이름까지 남의 것을 쓰는 이유는 무엇인가
이 서버는 오픈AI가 쓰는 목소리 이름을 그대로 노출합니다. alloy·nova·onyx를 부르면 내부적으로 자기 엔진에 연결해줘요.
이건 호환이 아니라 이식 비용 설계입니다.
같은 기능을 제공하는 것과, 기존 코드를 안 고쳐도 되게 만드는 것은 다른 결정입니다. 전자는 새 SDK를 하나 더 배우게 하고, 후자는 배울 게 없습니다. 이 프로젝트는 후자를 골랐어요. 자기 이름을 내걸 곳을 포기한 대가로, 옮겨오는 비용을 거의 0으로 낮춘 셈입니다.
바꿔야 하는 설정은 서버 주소 한 항목뿐이고, 인증 값은 형식만 맞으면 통과합니다. 검사하지 않거든요.
부를 수 있는 기능이 249개라는 건 무슨 뜻인가
문서에 등록된 항목이 249개입니다. 음성 만들기, 받아쓰기, 실시간으로 흘려보내기, 모델 설치까지 들어 있어요.
숫자보다 중요한 건 설치까지 코드로 된다는 점입니다. 손으로만 되는 단계가 하나라도 끼면 무인 파이프라인은 거기서 끊기거든요. 이 서버는 그 끊김을 안 남기려고 관리 기능까지 창구로 뺐습니다.
공식이 말하는 40배는 어느 구간을 잰 것인가
제 환경에서는 재현되지 않았습니다. 정상 상태에서 실제 재생 시간 대비 5~9배였어요.
세 번 잰 값을 놓고 보면 이유가 보입니다. 처음 부르는 순간에는 모델 3.1GB를 받아오느라 286초가 걸리고, 준비가 끝난 뒤 두 번째 세 번째는 1초에서 2초 사이로 떨어집니다. 새로 만든 목소리도 처음 한 번은 148초를 씁니다.
즉 첫 값에는 내려받기가 섞여 있습니다. 홍보 수치가 어느 구간을 잰 것인지 명시가 없어서, 저는 제가 잰 값을 씁니다. 다만 이건 그래픽카드 한 대에서 나온 숫자라 다른 환경에서는 달라질 수 있어요.
이 설계는 무엇을 포기했는가 — 제가 틀렸던 자리
여기서 한 번 크게 틀렸습니다.
저는 이 도구를 대본 음성 파이프라인에 바로 물렸습니다. 같은 입력이면 같은 파일이 나올 거라고 전제했거든요. 그 전제가 깨졌습니다.
원인은 셋으로 갈렸습니다. 첫째, 이 엔진은 결과를 고정하는 장치를 지원하지 않습니다. 둘째, 제 배치는 만든 파일을 덮어쓰고 있었습니다. 셋째, 자막 타이밍이 생성 길이에 묶여 있었습니다.
그래서 세 곳을 고쳤습니다. 만든 파일에 회차 번호를 붙여 남기고, 채택본을 사람이 고르는 단계를 넣고, 자막은 생성이 끝난 뒤 실제 길이로 다시 맞추게 했습니다.
왜 이 성질을 결함이라고 부르지 않는가
결과가 안 붙박이는 건 이런 방식 엔진의 성질에 가깝습니다. 같은 참조 음성을 매번 새로 해석하는 방식이라 그래요.
그래서 판정을 이렇게 나눕니다. 한 번 뽑아 보관하는 작업에는 문제가 되지 않습니다. 오히려 매번 미세하게 다른 편이 자연스럽게 들리기도 합니다. 반대로 만든 것을 여러 번 다시 뽑는 게 전제인 작업에는 부담이 됩니다. 견줄 바닥이 매번 새로 깔리거든요.
같은 조건에서 견주면, 클라우드는 재현성을 주는 대신 호출마다 과금하고 이쪽은 과금이 없는 대신 재현성을 안 줍니다. 둘 중 무엇이 내 프로젝트의 제약인지가 선택을 가릅니다.
안내 용량이 실제와 어긋나는 건 문서 문제인가 설계 문제인가
설치 화면이 안내하는 숫자에는 말을 알아듣는 쪽 모델이 빠져 있습니다. 더빙·받아쓰기·오디오북을 시키면 그때 응답이 옵니다.
HTTP 409
{
  "error": "asr_model_missing",
  "missing_repo_id": "Systran/faster-whisper-large-v3",
  "recommended": { "size_gb": 2.9 }
}
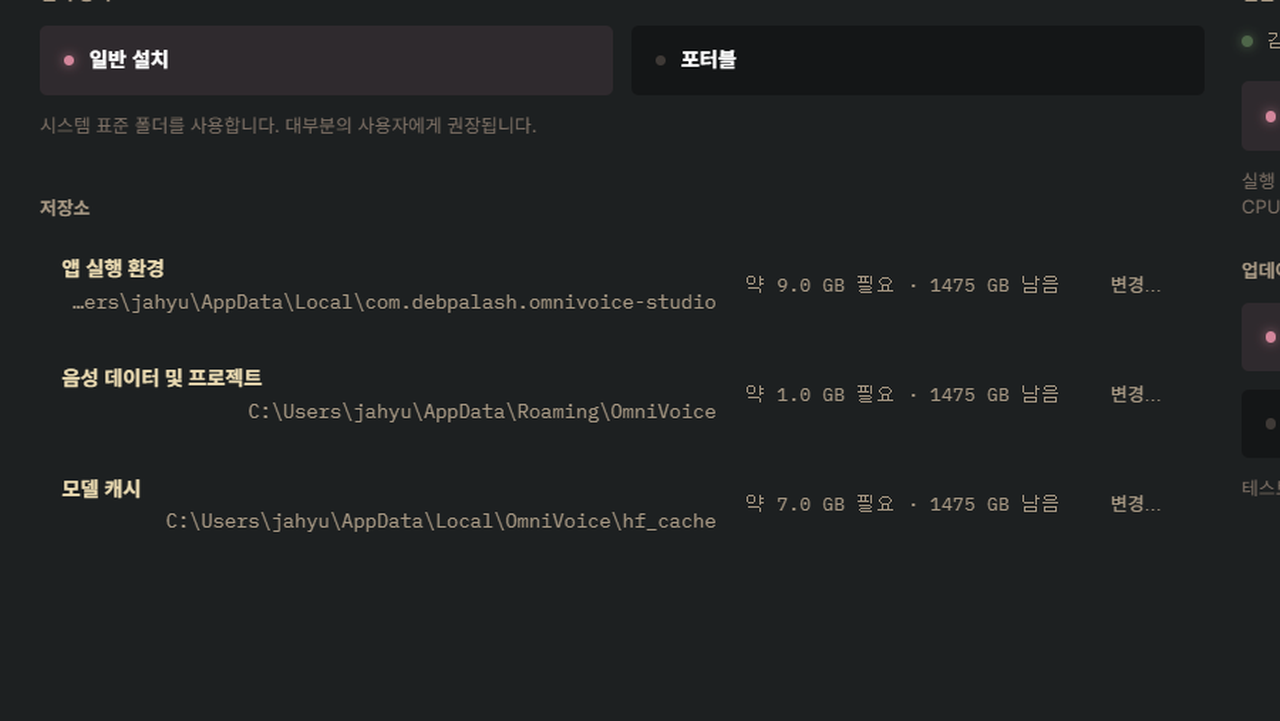
이 응답을 보고 저는 오히려 설계 의도를 이해했습니다. 필요한 사람만 받게 하려고 기본에서 뺀 겁니다. 안 쓰는 사람에게 몇 기가를 미리 안기지 않겠다는 결정이에요.
문제는 그 결정이 설치 화면 안내에 반영돼 있지 않다는 것뿐입니다. 응답 자체는 빠진 항목 이름과 크기까지 알려주니 친절한 편이고요.
그래픽카드 메모리 8GB는 왜 경계선이 되는가
받아쓰기와 음성 생성이 같은 장치를 동시에 쓸 때, 여유가 부족하면 만드는 쪽이 그래픽카드를 못 쓰고 프로세서로 넘어갑니다. 실패하지는 않고 느려집니다.
그래서 이 경계 아래에서는 두 작업이 같은 시간에 겹치지 않게 짜는 편이 낫습니다. 파이프라인이라면 받아쓰기 단계와 생성 단계를 순차로 두면 되고요.
라이선스는 결과물이 아니라 배포 방식을 묶는다
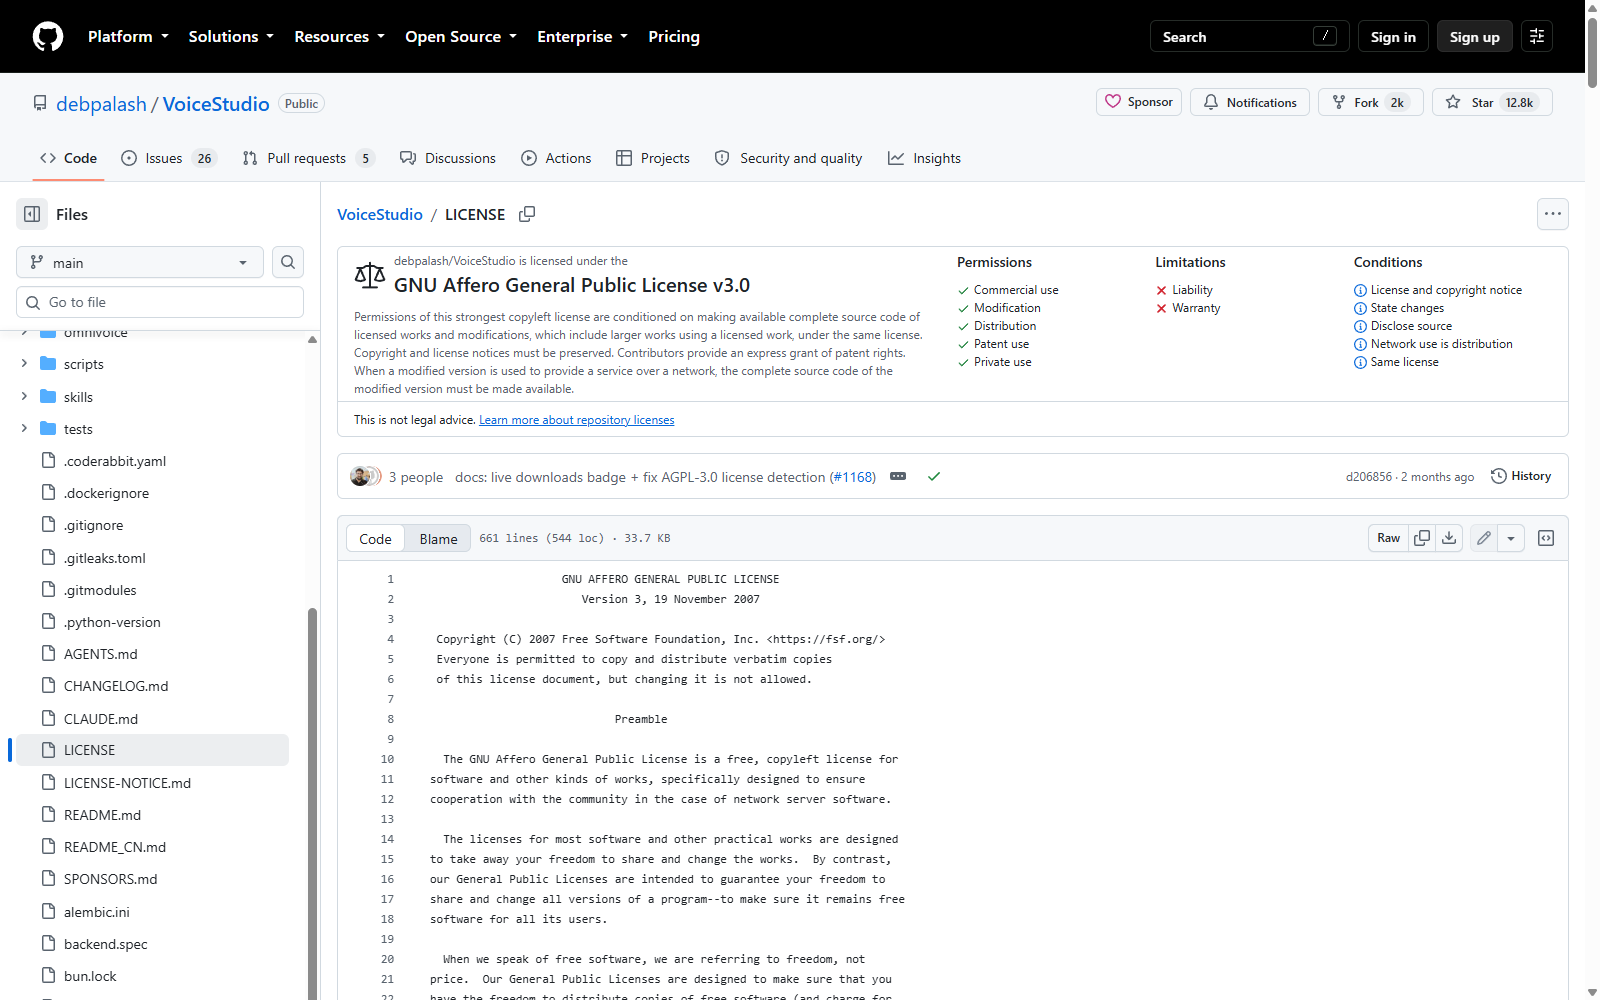
AGPL 3.0입니다. 법률 자문이 아니라 제가 읽은 내용입니다.
핵심은 제한이 걸리는 곳이 만든 음성 쪽이 아니라 프로그램 쪽이라는 겁니다. 만들어진 음성을 상업적으로 쓰는 건 명확히 됩니다. 걸리는 건 이 프로그램을 개조해 네트워크 너머로 서비스할 때고요.
그래서 사내에서 음성을 뽑아 쓰는 구성은 걸릴 게 없습니다. 이걸 감싸 SaaS로 파는 계획이라면 개발자에게 따로 문의해야 하고, 엔진마다 조건이 또 달라 쓸 엔진 것도 확인해야 합니다.
시작한다면 어디부터
앞에서 설계 결정을 넷 봤으니 확인할 것도 넷입니다.
- 목소리 목록 응답에 오픈AI 이름이 그대로 있는지 확인합니다 — 이식 비용이 정말 한 줄인지 여기서 확인됩니다
- 첫 호출 지연이 내 배치 첫 건을 세우지 않게 배치 바깥으로 뺍니다
- 만든 파일을 회차로 남기도록 고칩니다 — 재현이 안 되므로 원본이 곧 마스터입니다
- 받아쓰기를 쓸 계획이면 안내 용량 밖의 모델까지 계산에 넣습니다
여기까지 되면 나머지는 취향입니다. 반복 작업이 없다면 화면에서 클릭으로 써도 충분하고요.
처음에 던진 숫자를 다시 놓아봅니다. 설치에 쓴 17GB와 7분은 한 번만 내면 되는 값이었고, 상위 24편이 다루지 않던 249개 창구가 그 값을 회수해줬습니다. 다만 그 창구를 열려면 재현성을 내주는 거래에 동의해야 합니다. 저는 동의했고, 대신 배치를 세 곳 고쳤습니다.
마지막으로 하나 묻고 싶습니다. 결과가 고정되지 않는 생성기를 파이프라인에 넣어보신 적 있나요? 저는 배치를 세 곳 고쳤는데, 더 나은 처리 방법이 있으면 듣고 싶습니다.