클로드 프로젝트 지침, 유출본 22만 자 대신 넣을 문장 4개
클로드 유출 시스템 프롬프트 225,935자를 섹션별로 재보니 지침으로 쓸 수 있는 건 0.9%였습니다. 앤트로픽이 직접 배포한 문장 4개와 그 근거를 정리했습니다.
방구석컴퍼니
혼자 일하는 사람 · 작업 기록
깃허브에 올라온 클로드 시스템 프롬프트 파일을 받아서 글자 수를 세봤습니다. 225,935자. 이걸 프로젝트 지침 칸에 통째로 넣으라는 얘기가 커뮤니티에 돌길래, 붙여넣기 전에 안을 열어봤습니다. 결론부터 적으면 그중 지침으로 굴러갈 부분은 0.9%였고, 그 0.9%조차 앤트로픽이 자기 사이트에 이미 공개해 둔 내용이었습니다.
유출본 225,935자의 실제 구성
파일을 최상위 섹션 단위로 쪼개서 각 덩어리의 문자 수를 셌습니다. 결과는 예상과 달랐습니다.
| 섹션 | 문자 수 | 비중 | 성격 |
|---|---|---|---|
| functions | 67,585 | 30.0% | 도구 정의(JSON 스키마) |
| memory_filesystem | 44,408 | 19.7% | 메모리 도구 사용법 |
| search_instructions | 30,916 | 13.7% | 웹검색 도구 사용법 |
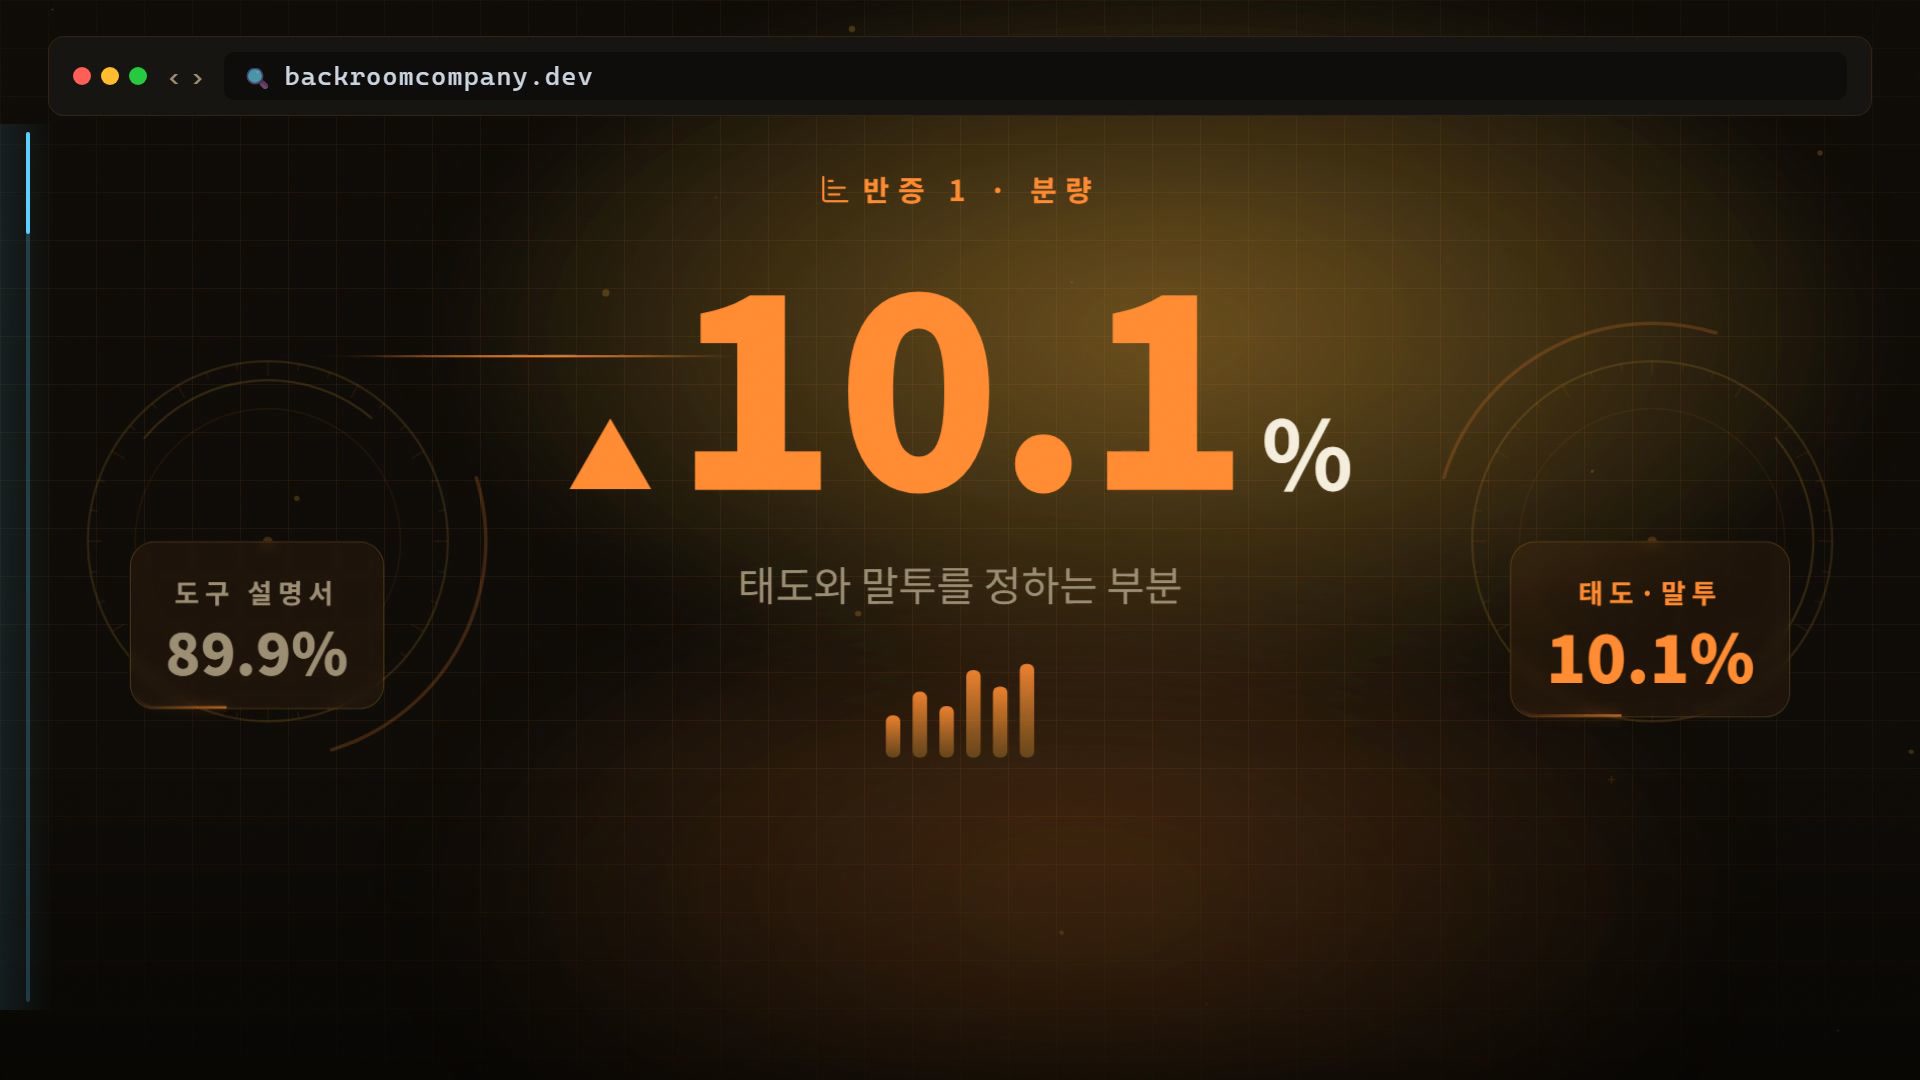
| claude_behavior | 22,809 | 10.1% | 일하는 태도·말투 |
| 그 외 12개 섹션 | 약 59,000 | 26.5% | 도구·설정 |
우리가 지침 칸에 원하는 건 네 번째 줄, claude_behavior 하나입니다. 나머지 89.9%는 클로드가 자기 도구를 호출하는 방법에 대한 설명서입니다. 검색은 이런 형식으로 부르고, 메모리는 이런 규칙으로 저장하라는 내용이죠. 그 도구들은 우리 채팅창에 존재하지 않습니다. 없는 기계의 사용설명서를 냉장고에 붙여두는 것과 같습니다.
여기서 한 번 더 좁힐 수 있습니다. claude_behavior 안에서 글쓰기 방식에 직접 관여하는 tone_and_formatting만 재면 2,105자입니다. 전체의 0.9%입니다.
쓸모 있는 10%는 앤트로픽이 이미 공개해 뒀다
앤트로픽은 claude.ai의 코어 시스템 프롬프트를 공식 릴리스 노트에 게시하고 있습니다. 모델별로 날짜까지 붙어 있고, Fable 5는 2026년 6월 9일자입니다.
공개 항목을 유출본 claude_behavior의 하위 섹션과 대조해보면 정확히 겹칩니다. product information, refusal handling, tone and formatting, user wellbeing, knowledge cutoff, evenhandedness, responding to mistakes and criticism. 공식이 뺀 건 딱 하나, 도구 정의입니다. 그리고 그 도구 정의가 바로 우리가 못 쓰는 89.9%입니다.
정리하면 이렇습니다. 유출본에서 값어치 있는 부분은 공식 페이지에 있고, 공식에 없는 부분은 우리에게 쓸모가 없습니다. 깃허브에서 22만 자를 받을 이유가 사라집니다.
커뮤니티 축약본의 5단계 워크플로우는 원문에 없다
유출본이 너무 기니까 핵심만 추렸다는 축약 지침이 돌아다닙니다. 그 문서의 간판은 다섯 단계짜리 워크플로우입니다. 범위 잡기, 근거 수집, 문제 풀기, 검증, 보고. 순서대로 밟게 하면 일을 잘한다는 논리죠.
원문에서 그 문구들을 검색했습니다.
| 검색어 | 채팅 프롬프트 | Claude Code 프롬프트 |
|---|---|---|
| gather evidence | 0회 | 0회 |
| phases in order | 0회 | 0회 |
| success criteria | 0회 | 0회 |
| never present unverified | 0회 | 0회 |
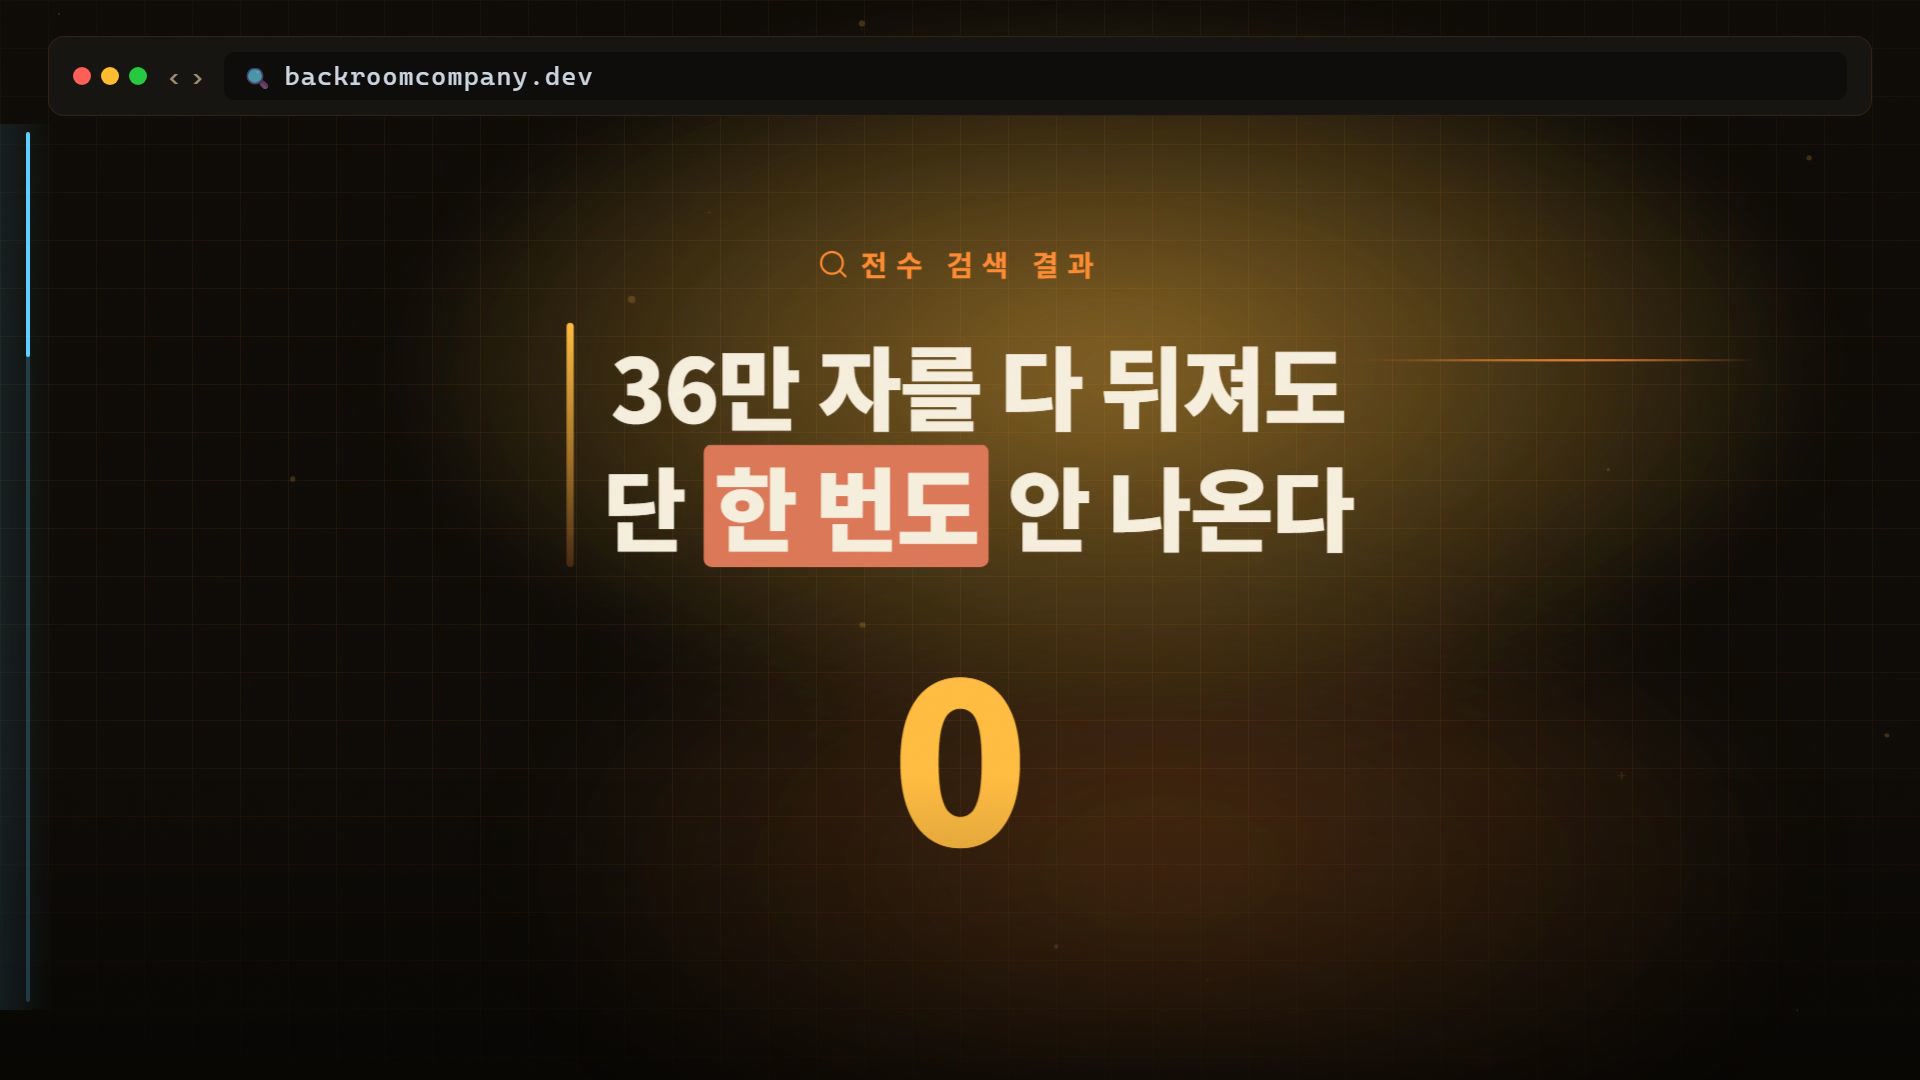
채팅용 225,935자에 개발자용 140,197자를 합쳐 366,132자를 전수로 뒤졌는데 한 번도 나오지 않습니다. 그 다섯 단계는 어느 유출 파일에도 없는, 작성자가 만든 문장입니다.
다만 공정하게 짚을 게 있습니다. 그 축약본에서 말투와 형식을 다룬 부분은 공식 공개본을 충실히 요약한 것이라 정확합니다. 프롬프트로서 효과가 없다는 뜻도 아닙니다. "이게 Fable의 진짜 지침"이라는 라벨만 사실이 아닌 겁니다.
앤트로픽이 직접 배포한 문장 4개
앤트로픽에는 시스템 프롬프트 공개 페이지와 별개로 프롬프트 작성 가이드가 있습니다. 한국어판도 있고, 이 문장을 그대로 넣으라며 코드블록으로 떠먹여 준 스니펫이 들어 있습니다. 설명이 아니라 배포물입니다.
첫째, 정보가 충분하면 바로 하라.
When you have enough information to act, act. Do not re-derive facts already established in the conversation, re-litigate a decision the user has already made, or narrate options you will not pursue in user-facing messages. If you are weighing a choice, give a recommendation, not an exhaustive survey. This does not apply to thinking blocks.
모호하게 시키면 답은 안 주고 되묻기만 하는 증상을 잡습니다. 고를 게 있으면 후보를 늘어놓지 말고 하나를 추천하라는 지시가 들어 있습니다.
둘째, 결론부터 말해라.
Lead with the outcome. Your first sentence after finishing should answer "what happened" or "what did you find": the thing the user would ask for if they said "just give me the TLDR." Supporting detail and reasoning come after. Being readable and being concise are different things, and readability matters more.
답의 첫 문장이 무슨 일이 있었는지부터 말하게 만듭니다. 짧게 쓰라는 말과는 다르다고 원문이 못까지 박아 뒀습니다. 줄이는 건 화살표나 줄임말로 뭉개는 게 아니라 안 중요한 걸 덜어내는 거라고요.
셋째, 근거 댈 수 있는 것만 보고해라.
Before reporting progress, audit each claim against a tool result from this session. Only report work you can point to evidence for; if something is not yet verified, say so explicitly. Report outcomes faithfully: if tests fail, say so with the output; if a step was skipped, say that; when something is done and verified, state it plainly without hedging.
넷째, 물어보기 전엔 고치지 마라.
When the user is describing a problem, asking a question, or thinking out loud rather than requesting a change, the deliverable is your assessment. Report your findings and stop. Don't apply a fix until they ask for one.
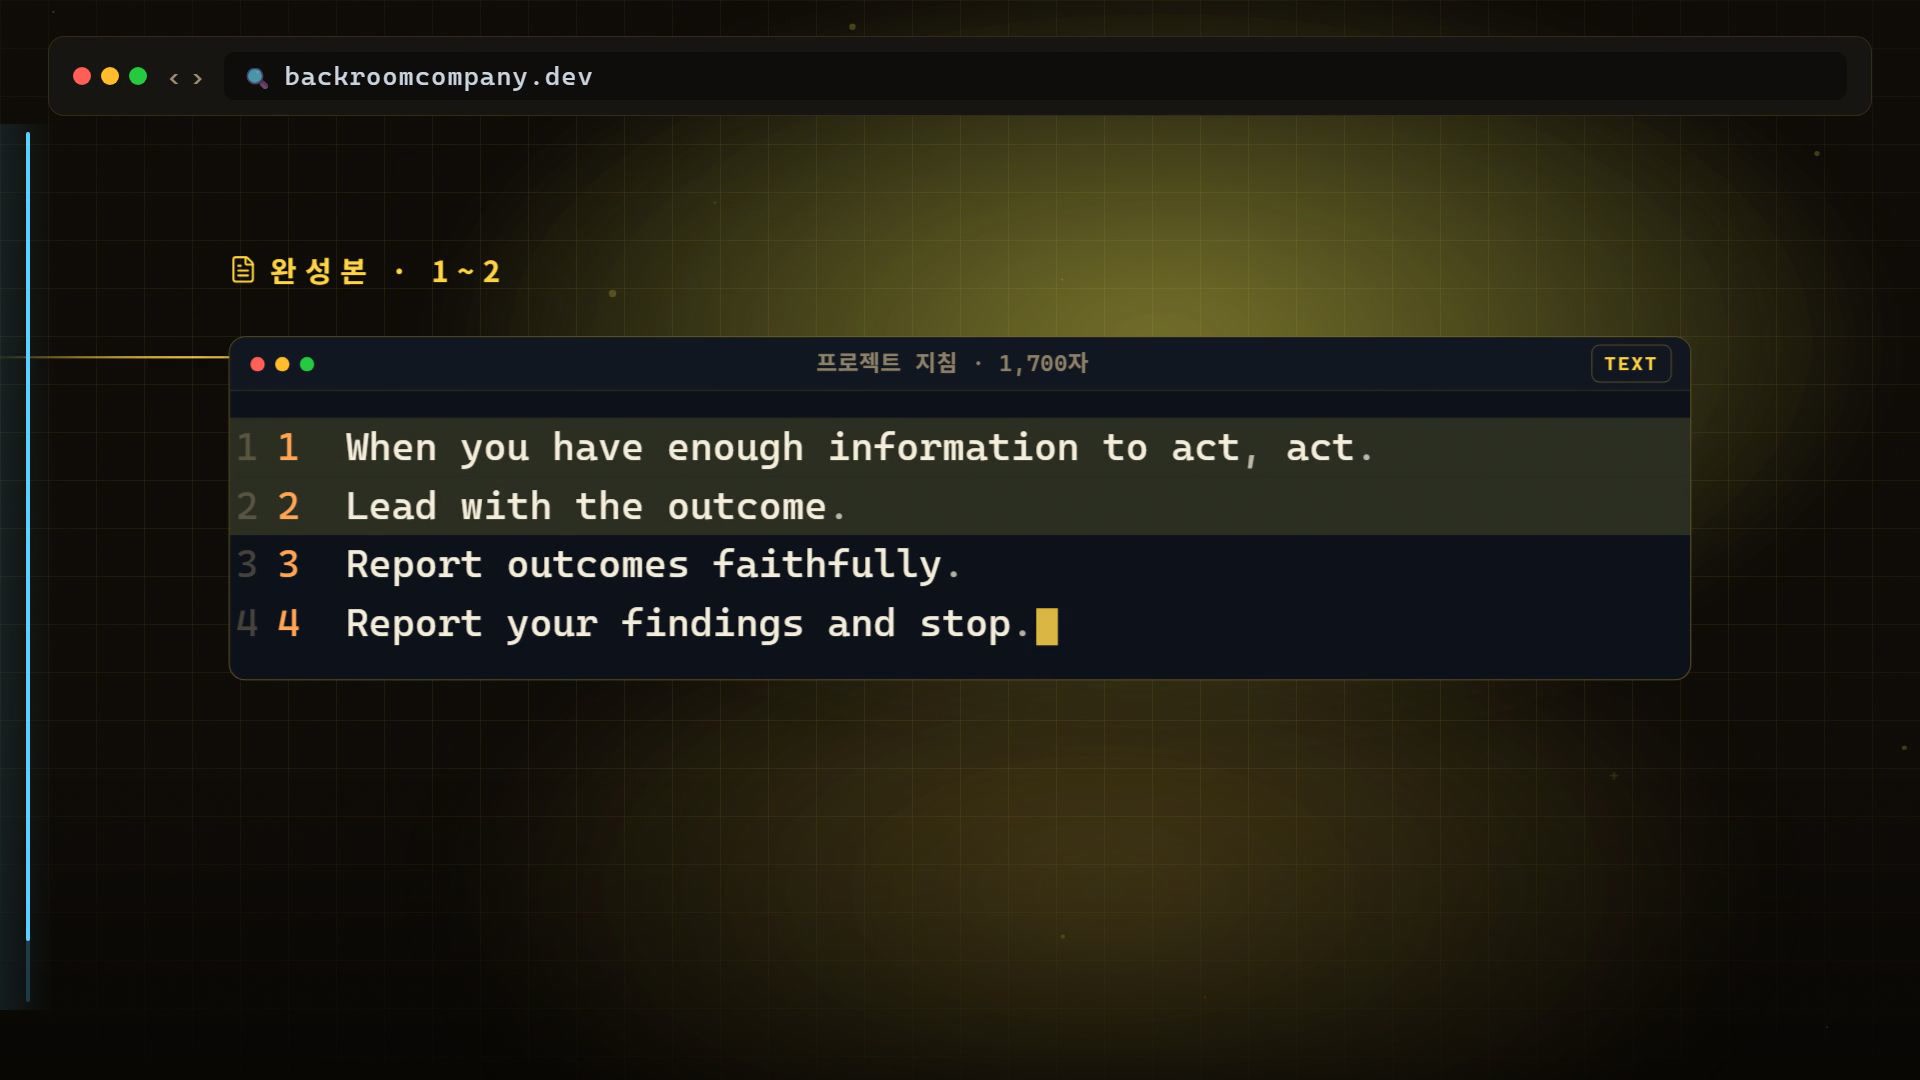
네 문장을 합치면 1,696자입니다. 유출본 225,935자의 0.75%입니다.
이 문장들이 진짜인지 확인하는 방법
권장 문구는 누구나 쓸 수 있습니다. 그래서 앤트로픽이 자기 제품에서도 같은 문장을 쓰는지 확인해봤습니다.
앤트로픽에는 클로드 코드라는 개발자용 제품이 있고, 그 시스템 프롬프트도 같은 저장소에 유출돼 있습니다. 그 파일을 열어 방금 네 문장을 검색했습니다.
| 문장 | 파일 내 위치 |
|---|---|
| Lead with the outcome | 2,178번째 글자 |
| Report outcomes faithfully | 4,545번째 글자 |
| When you have enough information to act | 9,845번째 글자 |
| When the user is describing a problem | 10,572번째 글자 |
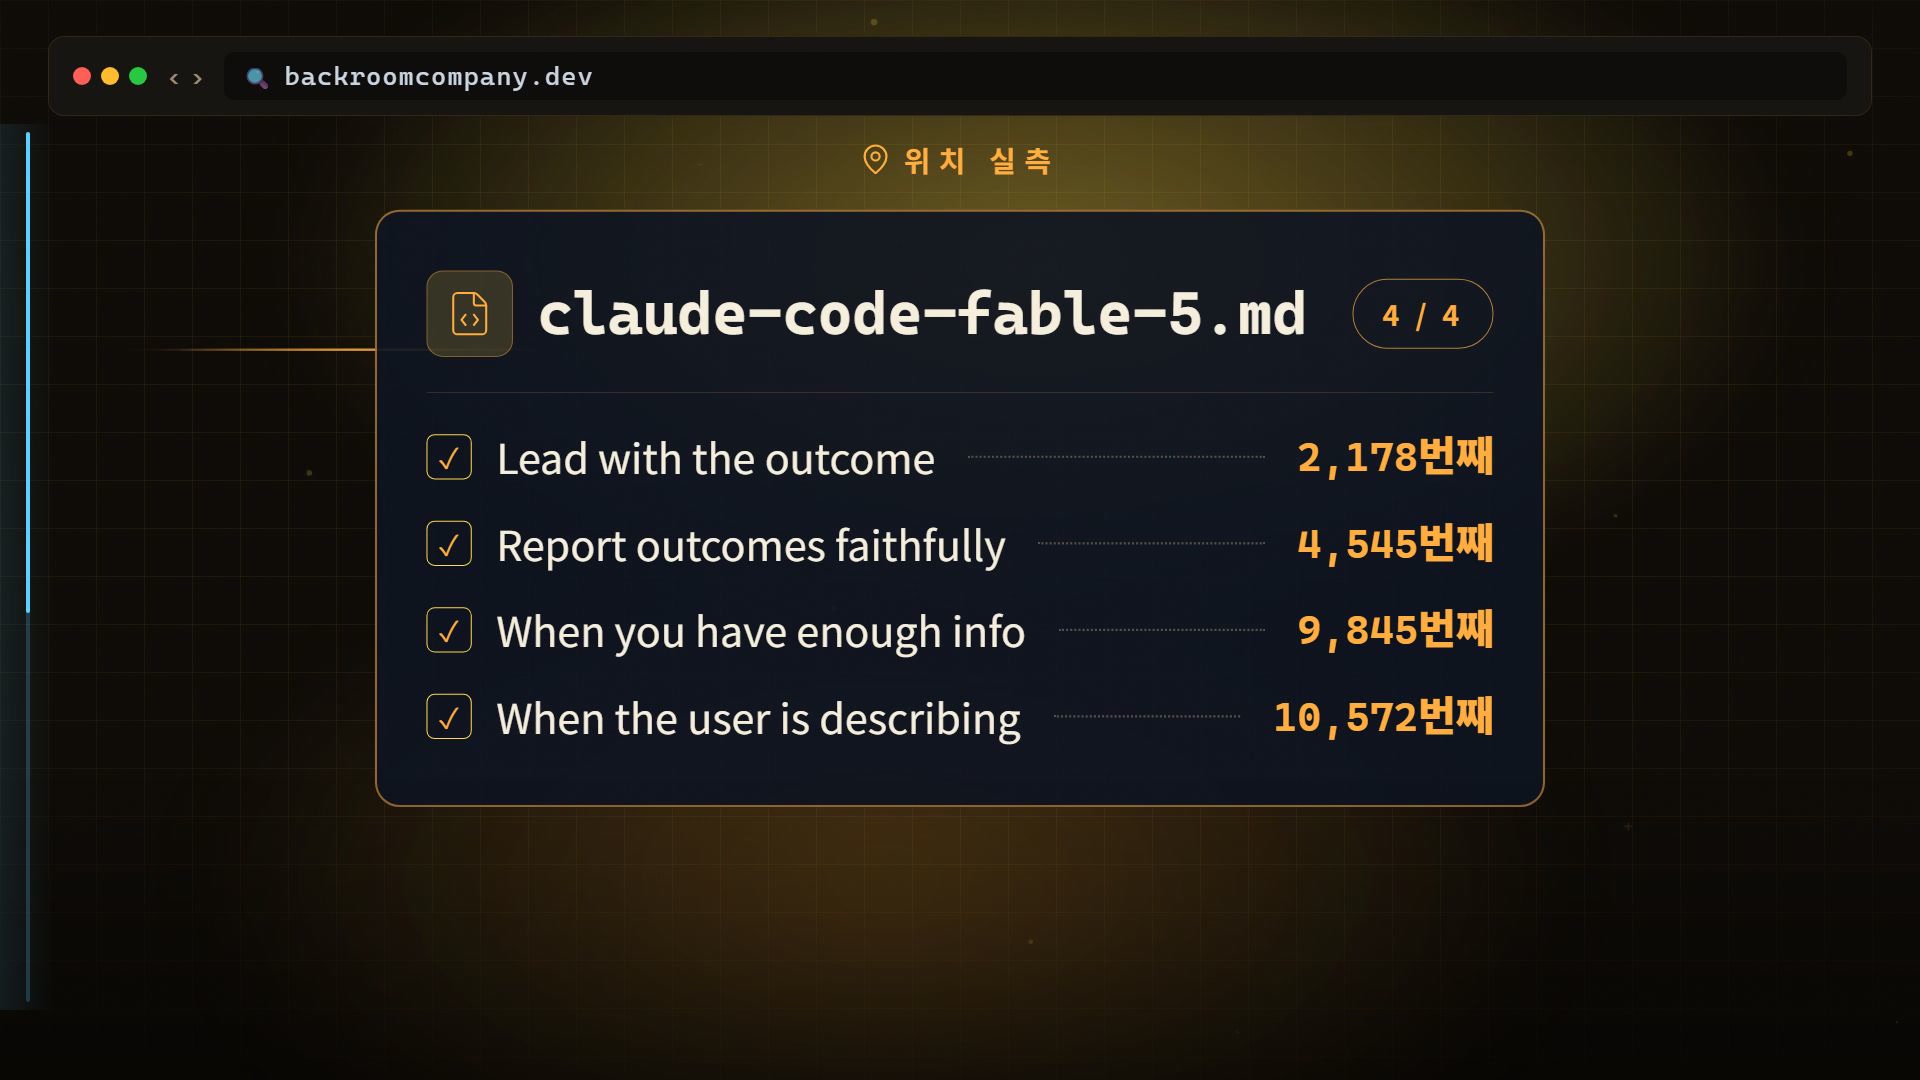
네 개 모두 문자 그대로 존재합니다. 요약해서 옮긴 게 아니라 같은 문장입니다. 권장만 한 게 아니라 자기들이 쓰고 있다는 뜻입니다.
정확히 하자면 세 번째 문장은 문단 전체가 아니라 뒷부분 한 문장이 일치합니다. 그리고 이건 2026년 6~7월 유출 스냅샷 기준이라, 지금 이 순간 가동 중인 프롬프트와 같다고 단정할 수는 없습니다.
넣지 말아야 할 것
같은 공식 가이드에 이런 문장이 있습니다. "이전 지시 사항을 검토하고 제거하는 것을 고려하세요." 이전 모델용으로 개발된 스킬은 너무 규범적인 경우가 많아 출력 품질을 저하시킬 수 있다는 겁니다. 단정이 아니라 그럴 수 있다는 표현입니다.
왜 그럴까요. 여러 연구가 공통으로 지적하는 현상이 있습니다. 입력이 길어질수록 모델 성능이 떨어지고, 특히 맥락의 중간에 묻힌 정보는 앞뒤보다 훨씬 덜 읽힙니다. 지시가 길고 잡음이 많으면 정작 중요한 제약이 묻히는 것도 같은 맥락입니다.
교과서를 형광펜으로 전부 칠하면 칠하지 않은 것과 같아집니다. 22만 자를 통째로 붙여넣는 건 제조사 권고와 정반대 방향인 셈입니다.
지침보다 먼저 만질 레버
공식 문서는 effort 설정을 "지능과 지연 시간, 비용 간의 트레이드오프를 제어하는 주요 수단"이라고 표현합니다. 채팅창에서 모델 이름을 누르면 나오는 메뉴에서 고르면 됩니다.
| 상황 | 권장 값 |
|---|---|
| 대부분의 작업 | high(기본값) |
| 역량이 가장 중요한 작업 | xhigh |
| 가벼운 일상 작업 | medium 또는 low |
항상 최대가 정답은 아닙니다. 높은 effort에서 일상적인 작업을 하면 필요 이상으로 컨텍스트를 수집하고 숙고할 수 있다고 공식 문서가 인정합니다. 커뮤니티에서 도는 "effort를 늘 최대로 두지 말라"는 조언은 이 대목과 정확히 겹칩니다.
솔직한 한계
이 네 줄을 넣어도 모델의 지능 자체는 바뀌지 않습니다. 달라지는 건 답변의 형식과 일하는 태도입니다. 싼 모델이 비싼 모델이 되지는 않습니다.
세 번째 문장은 원래 도구를 쓰는 장기 작업을 전제로 만들어졌습니다. 앤트로픽이 "거의 사라졌다"고 밝힌 효과도 도구 결과와 대조하는 상황에서 하지도 않은 일을 했다고 보고하는 문제에 대한 것입니다. 도구가 없는 일반 채팅에서는 효과 범위가 더 좁고, "확인 안 된 건 확인 안 됐다고 먼저 말하는" 쪽으로 체감됩니다.
정리
지침 칸을 채울 때 분량은 신뢰의 근거가 되지 못합니다. 22만 자를 붙여넣는 것보다 출처가 분명한 1,696자가 낫고, 그 출처는 깃허브가 아니라 제조사 문서입니다.
네 개를 다 넣는 게 부담되면 세 번째 문장 하나만 먼저 넣어보시길 권합니다. 지어내는 걸 잡는 문장이라 체감이 가장 큽니다.
지금 프로젝트 지침 칸에는 무엇이 들어 있나요? 궁금한 건 카카오 오픈톡 방구석모각코에서 물어보시면 됩니다.