AI 용어는 왜 6주마다 바뀌는가 — 공식 문서 2종을 대조해 남은 네 가지
프롬프트·컨텍스트·하네스·루프·그래프. 이름이 다섯 번 바뀌는 동안 OpenAI와 Anthropic 공식 문서에서 한 번도 빠지지 않은 항목만 추려낸 과정과 그 근거를 정리했습니다.
방구석컴퍼니
혼자 일하는 사람 · 작업 기록
새 용어가 나올 때마다 "이번엔 진짜 배워야 하나"를 판단해야 하는 사람을 위한 글입니다.
결론부터 적으면 이렇습니다. 프롬프트 엔지니어링에서 그래프 엔지니어링까지 다섯 번 이름이 바뀌는 동안, 벤더 공식 문서가 사람에게 요구한 항목은 네 개로 수렴합니다. 이 글은 그 네 개를 나열하는 게 아니라, 어떻게 그 네 개만 남았는지를 다룹니다.
이 글이 다루지 않는 것
각 용어의 정의나 따라하기 절차는 여기 없습니다. 이 글의 층위는 판별 근거입니다. 어떤 자료를 어떤 순서로 대조했고, 어디서 반증을 만났고, 그래서 무엇을 남겼는지가 본문입니다.
대조에 쓴 1차 자료
2차 해설이 아니라 만든 쪽이 직접 낸 문서만 씁니다. 커뮤니티 용어와 공식 명칭이 갈리는 지점을 잡으려면 이 구분이 필수입니다.
| 자료 | 발행 주체 | 대조에 쓴 부분 |
|---|---|---|
| GPT-5.6 프롬프팅 가이드 | OpenAI | 지울 것 / 남길 것 목록, 마이그레이션 절차 |
| Model guidance | OpenAI | leaner prompts 실측 수치 |
| Effective harnesses for long-running agents | Anthropic | 장기 실행 에이전트 구조 권고 |
| Claude Code 동적 워크플로우 문서 | Anthropic | 런타임 제약 수치 |
| Harness-Bench (arXiv:2605.27922) | 베이징대·Qiyuan Tech | 하네스 간 성능 격차 |
첫 번째 반증 — 명칭이 일치하지 않는다
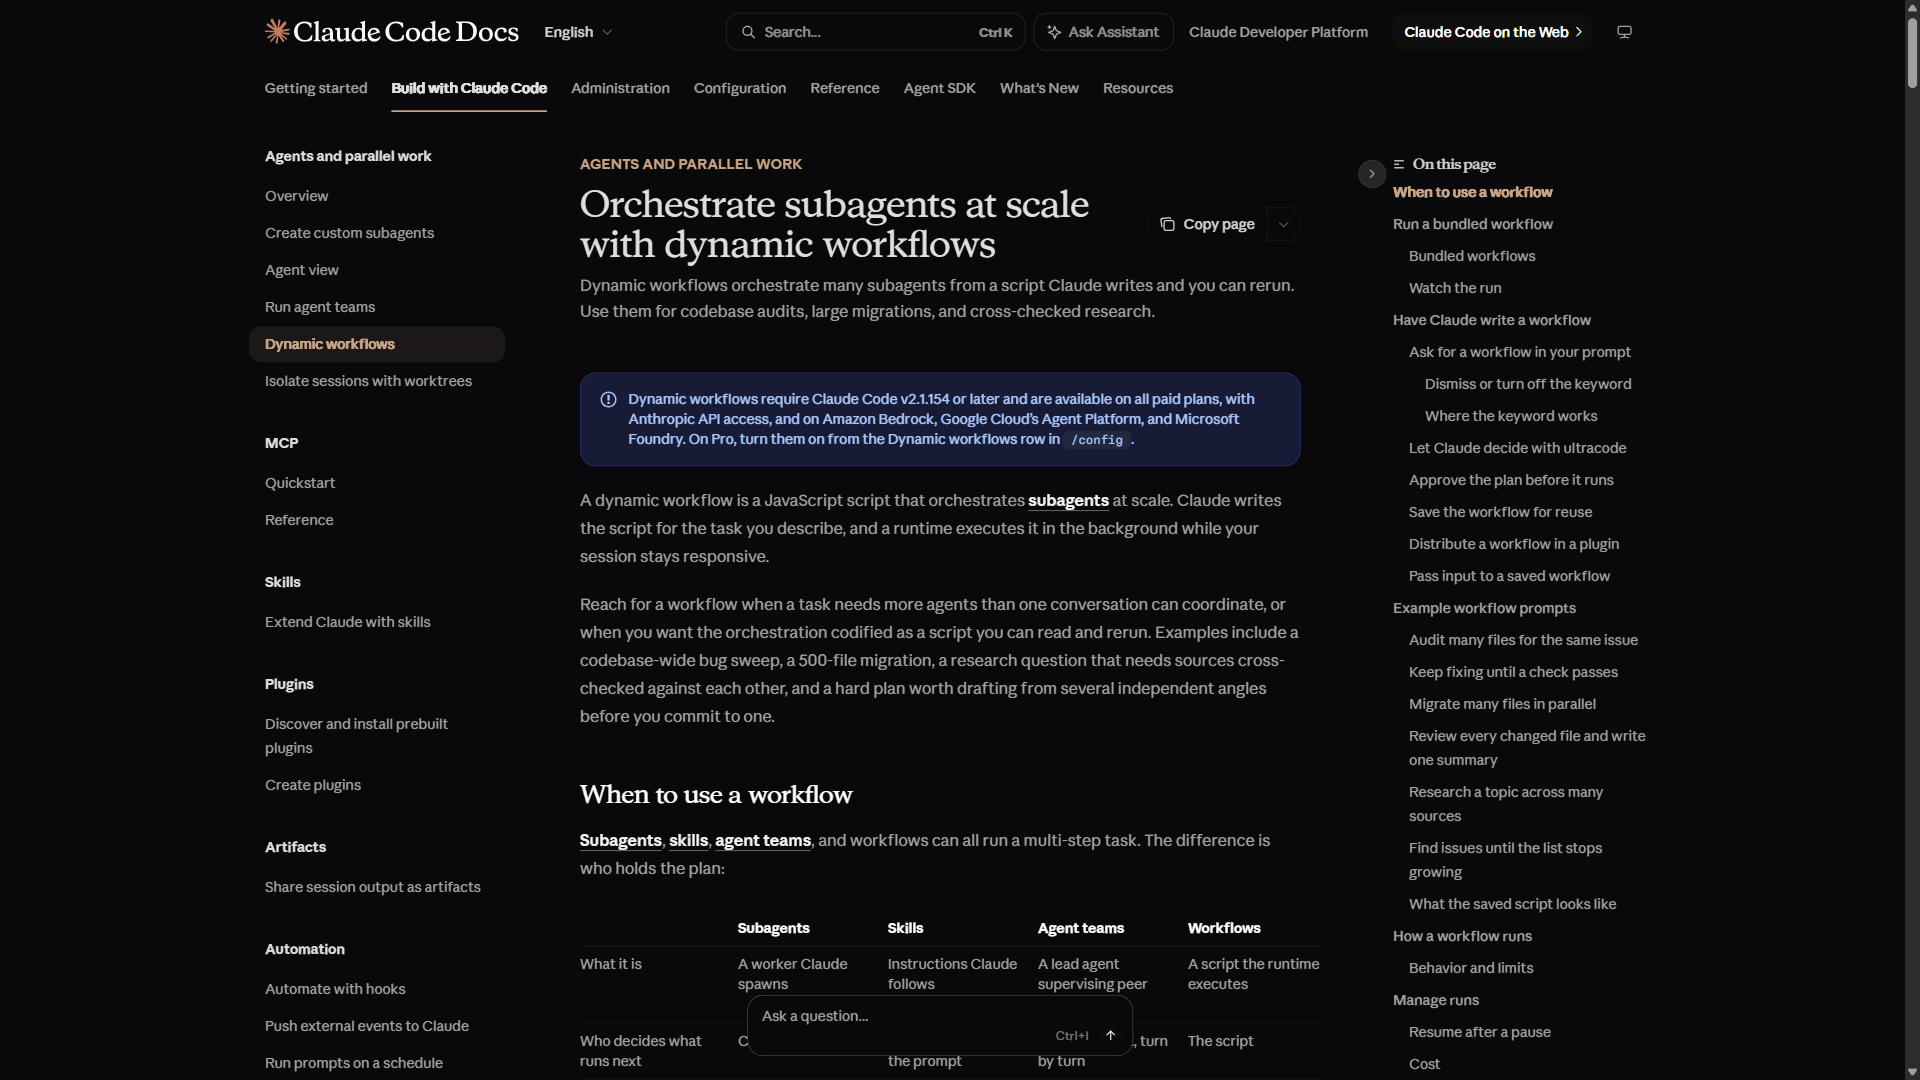 공식 문서의 기능명은 동적 워크플로우다
가설은 단순했습니다. 새 이름이 붙었으면 새 기술일 것이다. 확인은 이름 대조에서 바로 막혔습니다.
커뮤니티가 "그래프 엔지니어링"이라 부르는 기능은 Anthropic 문서에 그 이름으로 존재하지 않습니다. 문서에 적힌 명칭은 **동적 워크플로우(Dynamic workflows)**이고, 그래프 엔지니어링은 한 개발자의 정리 글에서 퍼진 표현입니다. 즉 이 층위에서 관찰되는 건 기술의 등장이 아니라 어휘의 등장입니다.
어휘가 먼저 생기는 이유
Turing Post FOD#159는 이 현상을 접근성 레이어로 설명합니다. 새로 생긴 건 개념이 아니라 그 개념을 쓰는 실무자 수라는 것입니다. 모델 신뢰도가 올라가고 프레임워크가 성숙하면 사용자가 늘고, 사용자가 늘면 공용 어휘가 필요해집니다.
이 설명은 검증 가능한 흔적을 남깁니다. 어휘가 개념보다 앞서면 어휘의 수명이 짧아야 합니다. 실제로 "루프 엔지니어링"은 약 6주 유통된 뒤 다른 표현에 자리를 내줬습니다.
두 번째 반증 — 기능은 실제로 추가된다
여기서 반대 방향의 사실도 잡힙니다. 이름만 바뀐 게 아닙니다. GPT-5.6은 툴을 순서대로 호출하는 경량 프로그램을 모델이 직접 작성하고, 실행을 감시하고, 중간 결과를 처리하고, 다음 행동을 고르는 동작을 공식 개선점으로 명시합니다.
원래 사람이 하던 오케스트레이션이 모델 쪽으로 넘어간 것은 사실입니다. 그러므로 "전부 마케팅"이라는 결론은 자료가 지지하지 않습니다.
그럼에도 사람에게 남는 자리
같은 문서가 이어서 요구하는 게 있습니다. 어떤 도구까지 허용할지, 결과를 어떤 형식으로 받을지, 어디서 중단할지는 사람이 미리 정해두라는 요구입니다.
넘어간 것은 실행이고, 경계는 그대로 사람 몫입니다. 이 비대칭이 네 개가 남는 구조적 이유입니다.
권고가 한 버전 만에 뒤집힌 사례
용어보다 더 빠르게 바뀌는 건 권고입니다. GPT-5.5 가이드가 권장하던 세 가지를 GPT-5.6 가이드는 제거 대상으로 지목합니다.
| 항목 | GPT-5.5 | GPT-5.6 |
|---|---|---|
| XML 지속성 블록 | 넣으라 | 걷어내라 |
| 컨텍스트 수집 템플릿 | 넣으라 | 걷어내라 |
| 단계 서술 프리앰블 | 넣으라 | 걷어내라 |
권고를 성실히 따른 사용자일수록 다음 버전에서 제거 작업이 늘어납니다. 이 관찰이 "무엇을 학습 대상으로 삼을 것인가"를 다시 묻게 만듭니다.
남은 네 가지의 도출
OpenAI 가이드에서 제거 대상은 한자리에 정리돼 있지만, 유지 대상은 문서 여러 곳에 흩어져 있습니다. 흩어진 항목을 요구 성격별로 묶으면 네 덩어리가 됩니다.
- 결과물 정의 — 작업 종료 시 사람이 실제로 받게 되는 산출물의 형태
- 성공 기준 — 통과 판정의 조건
- 중단 조건 — 종료 시점의 조건
- 하드 제약 — 모델이 넘을 수 없는 경계
결과물 정의를 뒷받침하는 실측
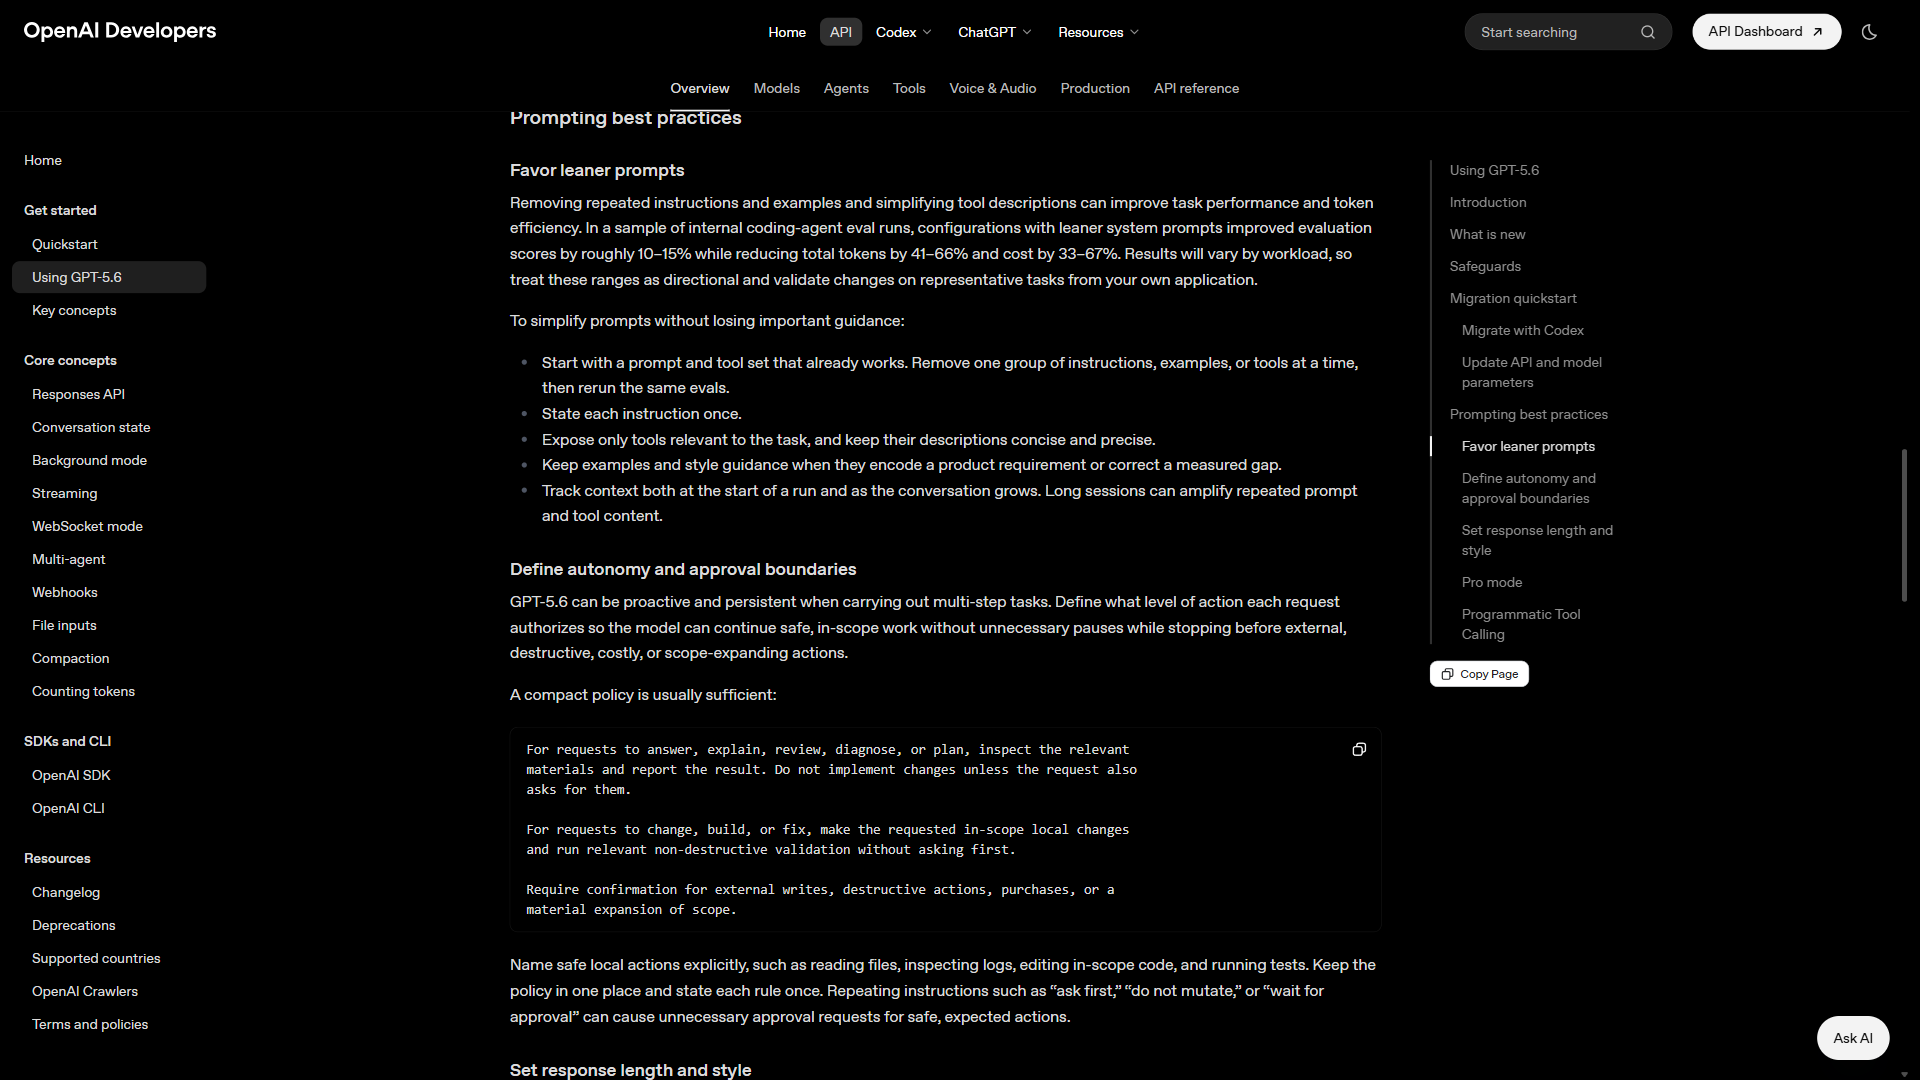 간소화 권고와 실측 수치가 같은 절에 적혀 있다
OpenAI는 사내 코딩 에이전트로 통제 비교를 했습니다. 과제와 모델을 고정한 채 시스템 프롬프트만 간소화한 조건입니다.
| 조건 | 평가 점수 | 총 토큰 | 비용 |
|---|---|---|---|
| 기존 프롬프트 | 기준 | 기준 | 기준 |
| 간소화 프롬프트 | +10~15% | −41~66% | −33~67% |
설명량과 성능이 같은 방향으로 움직이지 않는다는 게 요점입니다. 지시를 더 넣는 것이 개선이라는 직관이 여기서 깨집니다.
성공 기준을 자가 검증으로 대체할 수 없는 이유
"기준을 적는 대신 모델에게 재검토를 시키면 되지 않나"는 자연스러운 반론입니다. DeepMind가 ICLR 2024에 낸 실험이 이 반론을 직접 다룹니다.
| 자가 검토 결과 | 비율 |
|---|---|
| 오답 → 정답으로 교정 | 7.6% |
| 정답 → 오답으로 훼손 | 8.8% |
순효과가 음수입니다. 경계선은 채점 주체입니다. 모델이 자기 출력을 재평가하는 구조는 작동하지 않고, 테스트 통과 여부처럼 외부에서 판정 신호가 들어올 때 유효해집니다.
중단 조건이 벤더 설정으로 충분하지 않은 이유
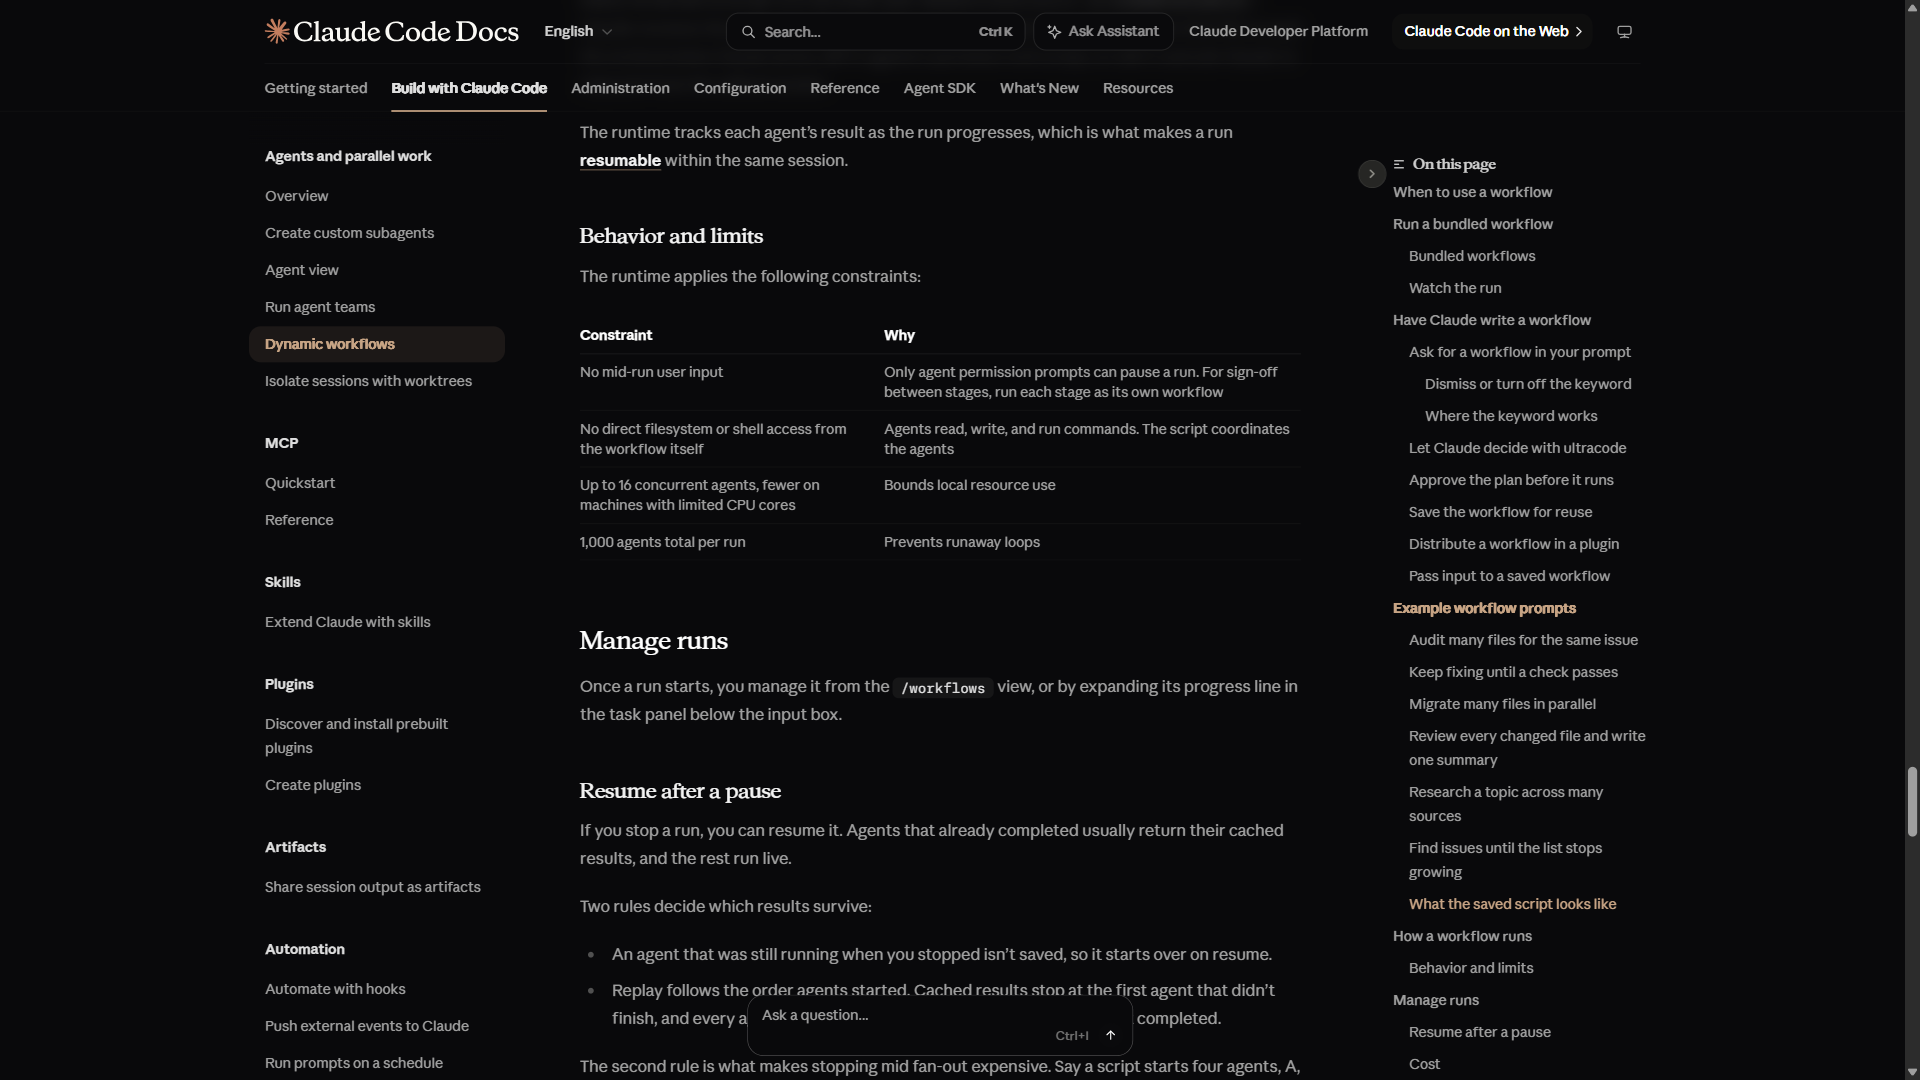 런타임 제약은 개수만 계측한다
Anthropic은 동적 워크플로우에 수치 제약을 걸어뒀습니다. 동시 실행 최대 16개, 1회 실행 총 1,000개이며 문서에 명시된 사유는 폭주 루프 방지입니다. 25개 초과 또는 예상 토큰 150만 초과 시 경고도 발생합니다.
다만 이 장치는 개수를 계측할 뿐 정답 여부를 계측하지 않습니다. 비용 상한과 "결과가 충분한 시점"은 계측 대상이 아니므로 사용자가 별도로 정의해야 합니다.
하드 제약이 가장 강한 항목인 근거
모델 성능 향상으로 완화 가능한 항목과 그렇지 않은 항목이 갈립니다. 후자를 지지하는 건 병목 이동 데이터입니다.
| 지표 | 변화 |
|---|---|
| 완료 과제 | +21% |
| 제출 작업 건수 | +98% |
| 사람의 검토 시간 | +91% |
METR이 숙련 오픈소스 개발자 16명에게 실제 과제를 주고 소요 시간을 측정한 실험에서는, 참가자 체감이 20% 단축인 반면 실측은 19% 증가였습니다. GitLab 2026 조사에서는 85%가 병목이 작성에서 검토로 이동했다고 답했습니다.
산출량이 늘수록 검토 면적도 함께 늘어나므로, 검토 없이 통과시킬 수 없는 경계를 사람이 고정해두는 일이 남습니다.
반대 증거 — 하네스는 여전히 성능을 가른다
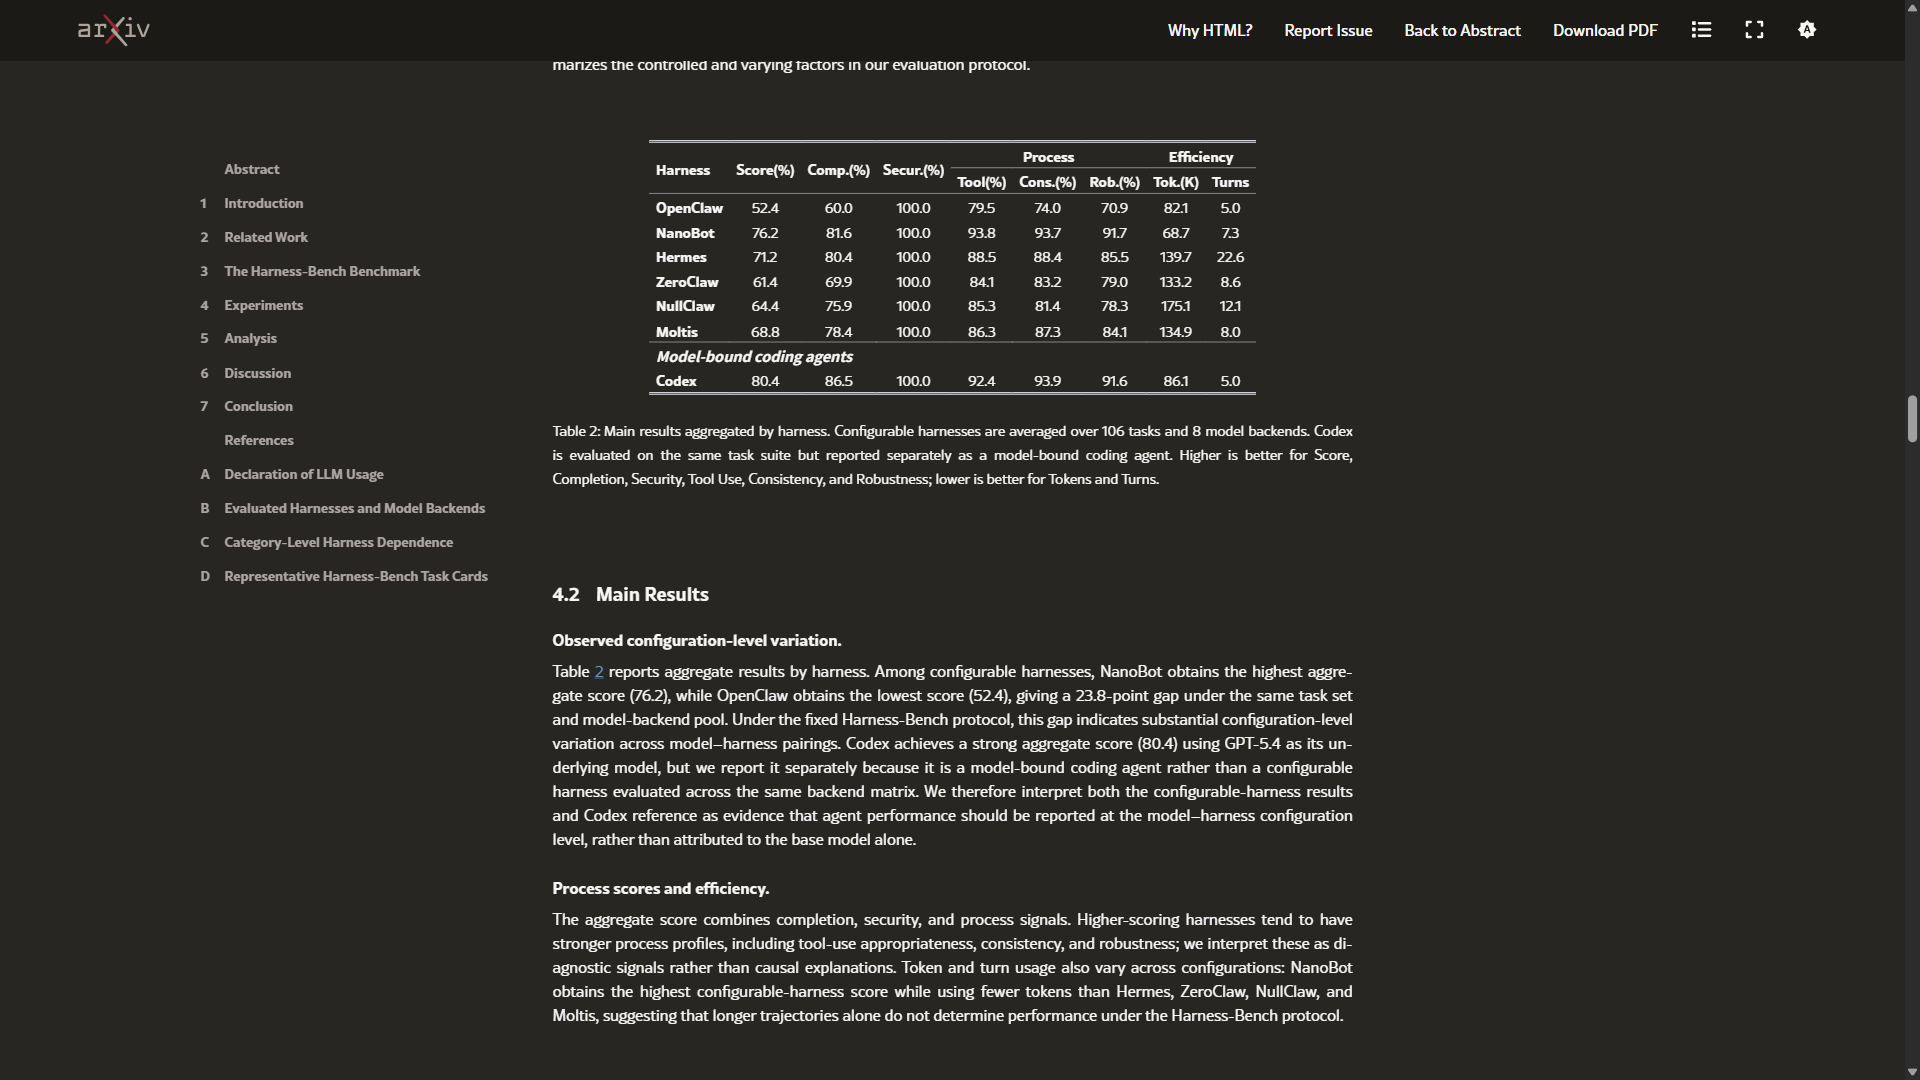 같은 과제·모델 풀에서 23.8%포인트 격차
여기까지만 보면 "네 개만 챙기면 하네스 자체는 불필요하다"는 결론으로 갈 수 있습니다. Harness-Bench가 그 결론을 막습니다.
과제 106개를 하네스 6종에 동일하게 얹고 모델 백엔드 8종으로 바꿔가며 5천 개 이상의 실행 궤적을 수집한 결과입니다.
| 하네스 | 집계 점수 |
|---|---|
| NanoBot | 76.2% |
| OpenClaw | 52.4% |
과제와 모델 풀이 같은 조건에서 23.8%포인트 격차가 발생합니다. 실행 껍데기의 설계가 성능을 가르는 변수라는 뜻입니다.
같은 논문이 남긴 반대 방향의 문장
단 같은 논문에 이런 관찰이 함께 있습니다. 모델이 강할수록 평균 점수는 높고 하네스 사이의 편차는 작다. 격차가 축소 방향이라는 신호입니다.
두 문장을 합치면 "하네스 소멸"이 아니라 의존도 감소가 자료에 맞는 서술이 됩니다.
만드는 쪽은 아직 손을 놓지 않았다
담론과 벤더 행동이 어긋나는 지점도 기록해둡니다. Anthropic Engineering이 2025년 11월 26일 게시한 글의 제목은 "Effective harnesses for long-running agents"입니다. 제목 자체가 하네스 제작 안내입니다.
Bun 개발자 Jarred Sumner의 기록도 같은 방향입니다. 코어를 다른 언어로 이전하는 작업에서 첫 번역이 한 바퀴 완료됐을 때 생성된 코드는 동작하지 않았고, 실질 성과는 실패를 구조화해 되먹이는 루프였습니다. 커밋마다 적대적 리뷰 2회를 통과시키는 구조가 그 루프의 핵심이었습니다.
완전 자동화를 목표로 두면 이 검토 단계가 가장 먼저 제거 대상이 됩니다. 목표 설정이 결과를 뒤집는 사례입니다.
이 정리의 한계
솔직하게 적어둡니다. 세 가지 한계가 있습니다.
첫째, Harness-Bench의 "편차 축소"는 시계열 관찰이 아니라 횡단면 결과입니다. 강한 모델과 약한 모델을 같은 시점에 비교한 것이지, 시간에 따라 격차가 줄어드는 것을 추적한 게 아닙니다. 추세로 읽을 때 이 구분이 필요합니다.
둘째, 네 개는 일반 업무 지시에 대한 판별 기준입니다. 장기 자율 작업이나 대규모 마이그레이션처럼 사람이 매 단계를 들여다볼 수 없는 작업에서는 하네스 설계가 여전히 성능을 결정합니다.
셋째, 수치는 2026년 8월 기준입니다. 한도와 요금은 자주 바뀌므로 실행 전 공식 문서 확인이 필요합니다.
공식 마이그레이션 절차
정리를 실행에 옮길 때 순서가 있습니다. OpenAI 문서가 제시하는 절차는 제거가 첫 단계가 아닙니다.
- 사용 모델만 교체하고 기존 설정은 유지
- 결과를 이미 아는 대표 과제로 평가 세트를 먼저 구성
- 항목을 한 덩어리씩 제거하며 같은 평가 세트를 재실행
제거 후보로 문서가 지목한 항목은 반복 규칙, 결과에 영향을 주지 않는 스타일 지시, 기능하지 않는 예시, 모델이 안정적으로 처리하게 된 절차 단계입니다.
정리
이름은 계속 바뀌고, 벤더 권고도 버전 단위로 뒤집힙니다. 그 아래에서 반복 관찰되는 요구는 결과물 정의·성공 기준·중단 조건·하드 제약 네 개이며, 각각 실측 근거가 붙어 있습니다.
새 용어를 만났을 때 학습 여부를 정하는 방법은 이렇습니다. 그 용어가 요구하는 것을 네 항목에 대보고, 전부 겹치면 어휘 교체로 처리합니다. 겹치지 않는 요구가 있으면 그때 학습 대상입니다.
여러분의 판별 기준은 몇 개인가요? 저는 이 네 개로 줄인 뒤로 새 용어 영상을 여는 빈도가 눈에 띄게 줄었습니다.
같은 주제를 영상으로도 정리했습니다. 유튜브 채널 방구석컴퍼니에서 볼 수 있고, 질문은 카카오 오픈톡 방구석모각코에서 받습니다.